一家从不分享照片的工厂,却学会了阅读标签
参考论文: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
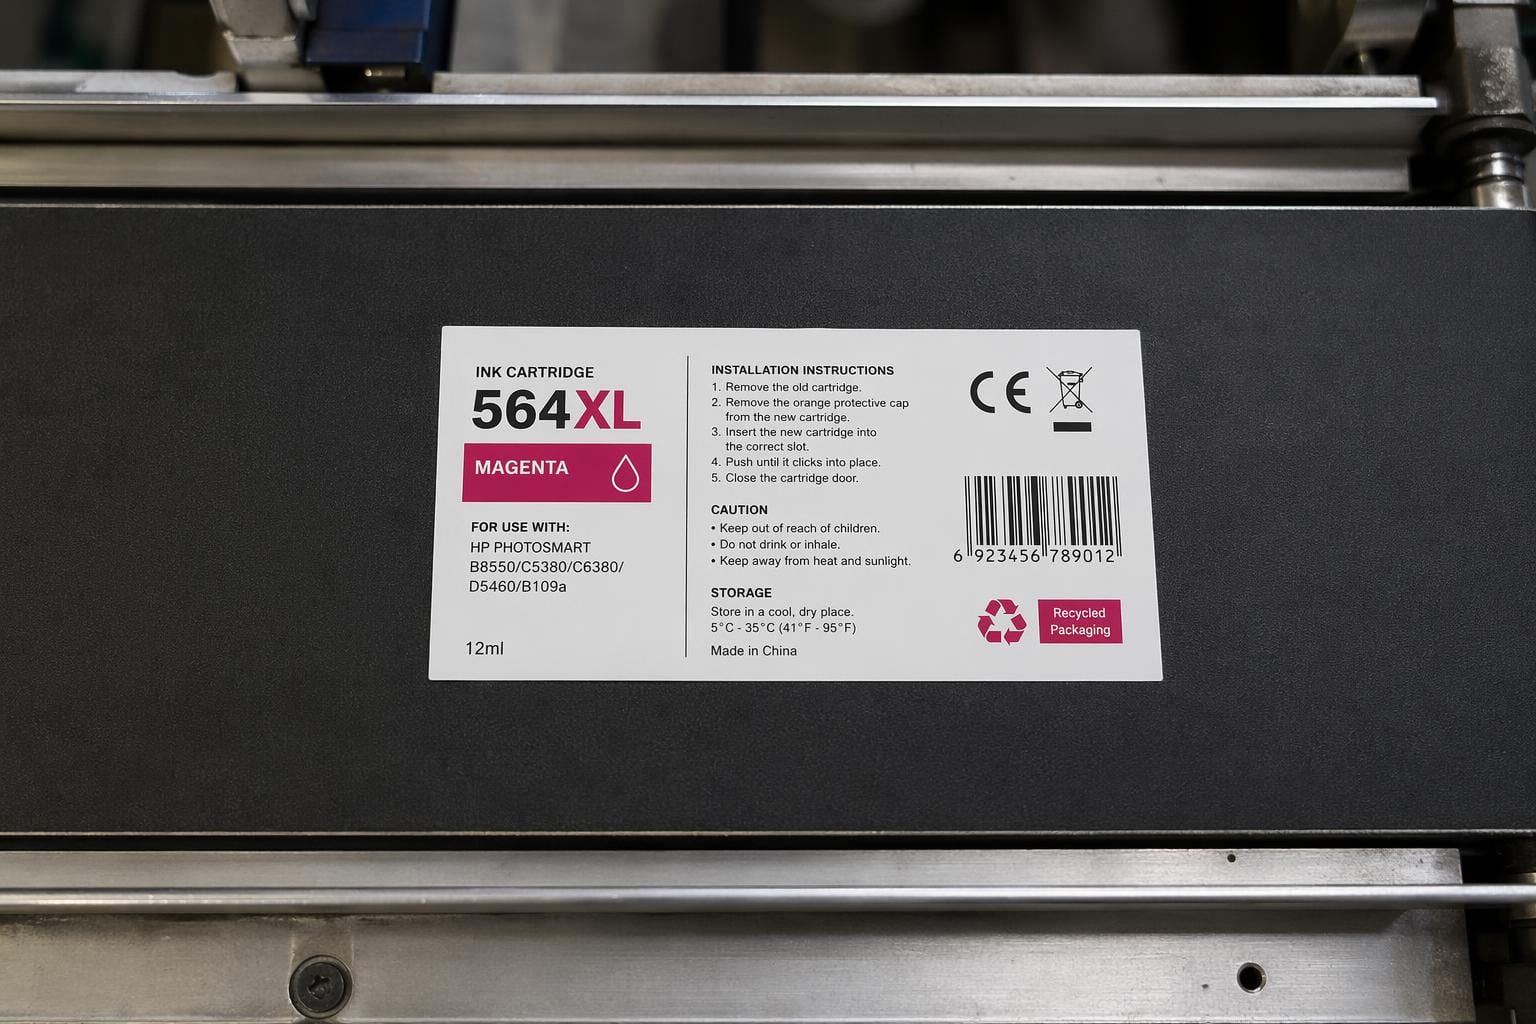
想象一下,同一家公司拥有三家墨盒工厂,分别位于深圳、槟城和金奈。每条生产线都装有摄像头,在标签经过时进行拍摄,以检查批次代码是否模糊、有效期是否印刷错误等。每家工厂可能只有几千张标注了缺陷的图片。由于这些图片展示了专有的标签设计、与客户合同绑定的批次号以及不愿流出厂区的内部质检数据,因此它们无法将这些图片发送到共享服务器。
这就是 FedTR 的背景,这是一篇由南洋理工大学及其行业合作伙伴组成的团队发表的新论文。他们解决的问题并不光鲜亮丽。这是一个不引人注目但极其普遍的情况:你需要一个优秀的 OCR 模型,但训练数据分散在各个站点,由于法律或合同限制,这些站点无法将数据汇总。
为什么这个问题比听起来更难
联邦学习(Federated Learning)早已作为“在无法集中数据的情况下进行训练”的解决方案而存在。其基本思路是:不再将数据发送到中央服务器,而是将模型分发到每个站点,让其在本地进行训练,然后仅将更新后的模型权重(而非图像本身)发送回中央服务器进行平均聚合。如此循环往复。没有任何工厂车间的照片会离开工厂。
该论文的核心主张是,普通的联邦学习在工业视觉检测领域会失效,值得我们深入探讨其原因。有两个因素同时对你不利:
- 数据量小。 进行标签质量检查的工厂可能总共只有几千张图像,而不是模型通常所需的数百万张。联邦学习试图用“金奈规模”的数据量来训练一个“金奈规模”的目标模型。
- 任务难度大。 这不仅仅是“是否有缺陷,是或否”的问题。它是端到端的文本识别:在标签上找到文本区域,然后逐字符、逐批次代码地正确读取文本。与二分类任务相比,这是一个容错率更低的任务,需要更多的信号才能学好。
小数据加上高难度任务,对于任何深度学习方法(无论是否联邦)来说都是一个糟糕的组合。将几个训练不足的模型进行平均,并不会产生一个训练良好的模型。它只会产生一个平均后的训练不足的模型。
解决方案:在联邦化之前先“借力”
FedTR 的应对策略是不从零开始进行联邦训练。具体步骤如下:
- 首先在一个大规模、公开且通用的文本识别数据集上训练模型。这就是迁移学习:模型从与墨盒无关的数据中学习通用技能,例如文本的外观特征、字符的形状,以及如何区分“6”和模糊的“8”。
- 只有在完成这一预训练阶段后,模型才会被分发到各个工厂,针对其小规模、私有且真实的实际数据进行联邦微调。
这里一个贴切的类比是招聘。你不会只给新员工三天的在职发票阅读任务,而不提供其他任何培训就指望他们学会阅读发票。你会雇佣一个已经具备阅读能力的人,然后教他们你特定的发票格式。FedTR 的做法也是如此:公共数据集教会模型通用的“阅读”能力,而联邦学习则教会它你工厂特有的字体、布局和缺陷模式。
这是一个合理的想法,坦率地说,也并非什么革命性的新点子。在其他领域,将迁移学习与联邦学习相结合的做法已有先例。该论文的实际贡献在于证明了这种方法在真正困难且具有商业现实意义的任务——即识别墨盒上充满缺陷的标签——中是有效的,并量化了其效果。
他们实际测试了什么,以及成本如何
团队在私有墨盒数据集上进行了实验,分为两种场景:
- 同构(Homogeneous): 各工厂的数据在统计上相似(标签样式相同,缺陷类型相近)。
- 异构(Heterogeneous): 各工厂的数据差异较大(标签设计不同,缺陷分布不同)。对于在全球不同国家生产不同产品的跨国公司而言,这是更困难、也更贴近现实的场景。
FedTR 在同构场景下达到了 95.5% 的词级准确率,在异构场景下达到了 94.2%。此处的“词级准确率”是指模型必须完整识别出整个单词才算正确,而不仅仅是大部分字符正确。这对于批次号等关键信息至关重要:例如在识别 "LOT4471X" 时,如果 10 个字符中只认对了 9 个,这被视为识别失败,而非 90% 的成功率。
值得驻足思考的一个数字是同构与异构场景之间的差距极小:仅 1.3 个百分点。联邦学习有一种众所周知的失效模式,即当客户端数据分布出现分歧时,性能会急剧下降(研究人员称之为“非独立同分布问题”,即 non-IID 问题,其中 IID 代表独立同分布,通俗地说就是“训练数据并非来自同一统计分布”)。这里的微小差距表明,迁移学习的预训练步骤确实在发挥作用,有效保护模型免受该失效模式的影响,而不仅仅是带来边际提升。
另一个关键数字是:FedTR 的联邦学习结果与集中式训练大致相当。集中式训练是指将所有数据汇总到一处训练单一模型,虽然在此场景下不被允许,但它代表了理论上的性能上限。在不汇总任何数据的情况下达到这一上限,正是该研究的核心目标,而论文用实际数据而非单纯断言来支撑了这一主张。
为什么在构建或采购 OCR 时这很重要
如果您正在为有数据驻留要求、多站点制造、跨医院系统的医疗记录或跨地区实体的金融文档等场景构建文档处理流水线,那么这篇论文提供了一个有用的数据点,表明“要么集中训练,要么干脆不训练”的权衡并不像表面看起来那样非黑即白。鉴于中文等表意文字系统拥有数千个字符且版面密集,若该研究仅针对英文/拉丁文本,其结论在直接迁移至中文 OCR 时需谨慎考量。
对于在此类环境中评估 OCR 的任何人,以下是几个具体的启示:
- 预训练比联邦机制本身更重要。 FedTR 的巧妙之处并不在于联邦平均(这大多是标准的),而在于拒绝从零开始进行联邦训练。如果您受限于数据孤岛,通常最具杠杆效应的举措是采用强大的通用基础模型,而非更复杂的聚合算法。
- 不要假设联邦学习是免费的午餐。 该论文诚实地指出,普通的联邦学习(FL)在小而难的数据集上表现不佳,这与许多从业者通过艰难方式发现的现实相符。如果有人向您推销“只需联邦化”作为解决数据孤岛问题的方案,请询问其基础模型是在什么数据上进行预训练的。
- 词级准确率才是应该要求的正确指标,而非字符级。 许多 OCR 营销倾向于使用字符准确率,因为这是一个更大、更好看的数字。对于任何解析整个字段(如批号、SKU、日期)的下游任务,字符准确率可能会掩盖一个在实际中毫无用处的模型。95.5% 的词准确率是一个真正强大的数字,恰恰因为它是一个更高的门槛。
缺失了什么,以及为何不应过度外推
该论文仅针对一家公司的墨盒标签进行了测试。这是一个真实、具体且具有商业意义的基准,但它仅代表单一产品类别和单篇论文中的私有数据集。所谓的“异构”设置实际上仍是同一家公司内部数据中的模拟变化,而非真正独立、标签规范差异巨大的不同组织。
此外,文中未讨论通信成本或达到收敛所需的联邦轮次,而这两点在实际应用中至关重要:在三家工厂之间往返传输模型更新几次尚可接受,但在三百家工厂(或真正的全球性企业)之间进行则完全是另一类基础设施难题。同时,文章也未与其他领域已出现的“迁移学习+联邦学习”组合方案进行对比,因此很难判断 FedTR 的具体方案是否优于其他显而易见的替代方案,还是仅仅因为它是首个在该数据集上尝试的方法。
尽管如此,其研究方向是正确的,且文中展示的结果与生产部署之间的差距属于正常的工程工作范畴,而非研究空白。在文档 AI 领域,许多已发表的研究从未触及真实、私有且涉及商业敏感性的数据集,因此使用来自真实制造合作伙伴的实际墨盒质检数据进行测试本身就具有价值。这区分了仅证明技术在基准上有效的论文,与证明其能在工厂车间环境中存活的论文。