Uma fábrica que nunca compartilha suas fotos, mas ainda assim aprende a ler rótulos
Baseado em: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
Imagine três fábricas de cartuchos de tinta pertencentes à mesma empresa, uma em Shenzhen, outra em Penang e outra em Chennai. Cada uma possui câmeras na linha de produção fotografando os rótulos à medida que passam, verificando se há códigos de lote borrados, datas de validade impressas incorretamente e problemas semelhantes. Cada fábrica tem talvez alguns milhares de imagens rotuladas de defeitos. Nenhuma delas pode enviar essas imagens para um servidor compartilhado, pois as imagens mostram designs proprietários de rótulos, números de lote vinculados a contratos de clientes e dados internos de controle de qualidade que ninguém quer que saiam do prédio.
Esse é o cenário por trás do FedTR, um novo artigo de uma equipe que abrange a Universidade Tecnológica de Nanyang e parceiros da indústria. O problema que eles estão resolvendo não é glamouroso. É a situação não glamorosa, mas extremamente comum, em que você precisa de um bom modelo de OCR, mas os dados de treinamento estão dispersos em locais que, por motivos legais ou contratuais, não podem agrupá-los.
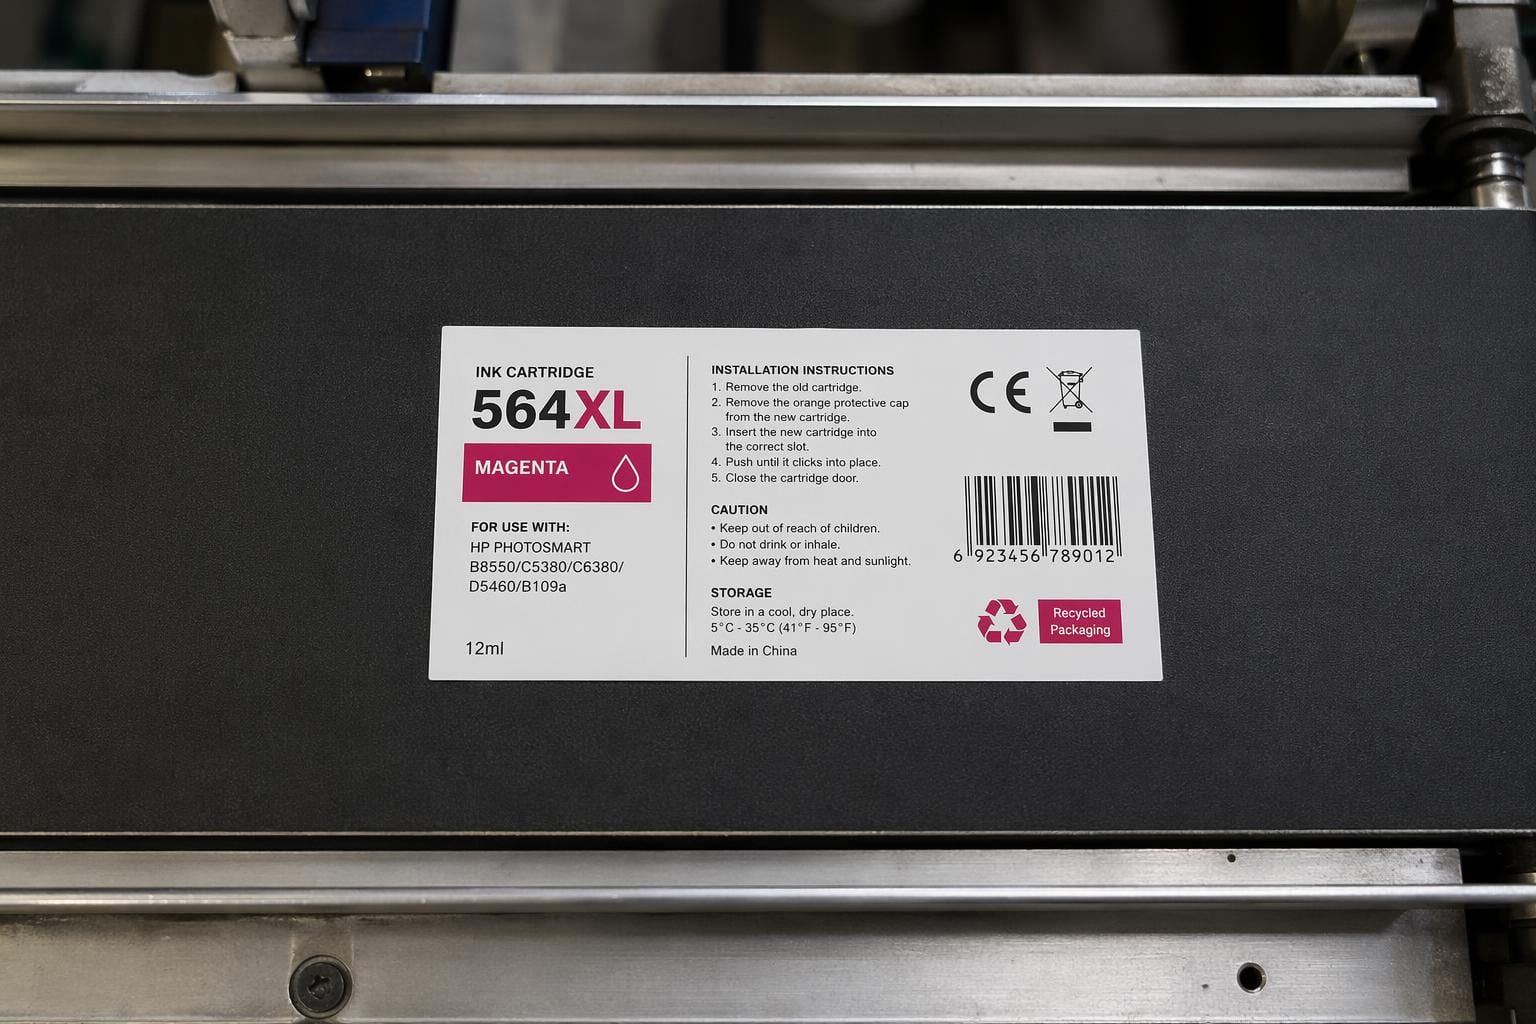
Por que este é um problema mais difícil do que parece
O aprendizado federado já existe como resposta ao desafio de "treinar com dados que não podem ser centralizados". A ideia básica: em vez de enviar os dados para um servidor central, você envia um modelo para cada local, permite que ele seja treinado localmente e, em seguida, envia de volta apenas os pesos atualizados do modelo (não as imagens) para serem agregados. Repita o processo. As fotos da linha de produção de ninguém saem da fábrica.
A afirmação central do artigo é que o aprendizado federado simples falha especificamente na inspeção visual industrial, e vale a pena refletir sobre o motivo. Dois fatores atuam simultaneamente contra você:
- Os dados são escassos. Uma fábrica que realiza controle de qualidade de rótulos pode ter apenas alguns milhares de imagens no total, não os milhões que um modelo normalmente necessita. O aprendizado federado tenta treinar um modelo para um objetivo de escala Chennai a partir de uma quantidade de dados de escala Chennai.
- A tarefa é complexa. Não se trata apenas de "há um defeito, sim ou não". É o reconhecimento de texto ponta a ponta: encontrar a região de texto no rótulo e, em seguida, lê-lo corretamente, caractere por caractere, código por código de lote. Essa é uma tarefa muito menos tolerante do que a classificação binária e requer mais sinal para aprender adequadamente.
Dados escassos combinados com uma tarefa complexa formam uma péssima combinação para qualquer método de aprendizado profundo, seja federado ou não. Agregar vários modelos subtreinados não produz um único modelo bem treinado. Apenas resulta em um modelo subtreinado agregado.
A solução: aproveitar conhecimento prévio antes de federar
A resposta do FedTR é não iniciar o treinamento federado a partir de um modelo em branco. Em vez disso:
- Treinar o modelo primeiro em um grande conjunto de dados público e genérico de reconhecimento de texto. Isso é aprendizado por transferência: o modelo aprende habilidades gerais, como o aspecto do texto, a forma dos caracteres e como distinguir um "6" de um "8" borrado, a partir de dados que não têm nada a ver com cartuchos de tinta.
- Somente após esse pré-treinamento o modelo é enviado às fábricas individuais para ajuste fino federado em seus pequenos conjuntos de dados privados e reais.
A analogia que realmente se sustenta aqui é a contratação. Você não treina um novo funcionário para ler faturas dando-lhe apenas três dias de faturas no trabalho e nada mais. Você contrata alguém que já sabe ler e, em seguida, ensina o formato específico de suas faturas. O FedTR faz exatamente a mesma coisa: o conjunto de dados público ensina o modelo a ler de forma geral, e o aprendizado federado ensina as fontes, layouts e padrões de defeitos específicos da sua fábrica.
É uma ideia razoável e, francamente, não é radicalmente nova. A combinação de aprendizado por transferência e aprendizado federado já foi tentada em outros domínios. O que o artigo realmente contribui é demonstrar que funciona e quantificar o quão bem funciona em uma tarefa genuinamente difícil e comercialmente relevante: ler etiquetas repletas de defeitos em cartuchos de tinta.
O que realmente testaram e o que custou
A equipe realizou experimentos em conjuntos de dados privados de cartuchos de tinta sob duas condições:
- Homogênea: os dados de cada fábrica são estatisticamente semelhantes entre si (mesmo estilo de rótulo, tipos de defeito similares).
- Heterogênea: os dados de cada fábrica são diferentes (designs de rótulo distintos, distribuições de defeitos diferentes). Este é o caso muito mais difícil e realista para uma empresa global com plantas que fabricam produtos diferentes em países diferentes.
O FedTR atingiu 95,5% de precisão em nível de palavra na configuração homogênea e 94,2% na heterogênea. A precisão em nível de palavra aqui significa que o modelo acertou a palavra inteira, e não apenas a maioria dos caracteres, o que é o padrão que realmente importa para algo como um código de lote: acertar 9 de 10 caracteres em "LOT4471X" é uma leitura falha, não um sucesso de 90%.
O número em que vale a pena pausar é o quão pequena é a diferença entre o cenário homogêneo e o heterogêneo: 1,3 pontos percentuais. O aprendizado federado tem um modo de falha bem documentado, no qual o desempenho despencam quando as distribuições de dados dos clientes divergem (os pesquisadores chamam isso de "problema não-IID", onde IID significa independentemente e identicamente distribuído, uma maneira elegante de dizer "seus dados de treinamento não vêm todos da mesma distribuição estatística"). Uma diferença pequena aqui significa que a etapa de pré-treinamento com aprendizado por transferência está fazendo um trabalho real de proteger o modelo desse modo de falha, e não apenas adicionando um ganho marginal.
O outro número de destaque: os resultados federados do FedTR estão aproximadamente no mesmo nível do treinamento centralizado, ou seja, treinar um único modelo com todos os dados reunidos em um só lugar, o que não é permitido aqui, mas serve como o limite teórico. Alcançar esse limite sem reunir nenhum dado é todo o propósito do exercício, e o artigo sustenta essa afirmação com números reais, em vez de apenas alegá-la.
Por que isso importa se você está construindo ou comprando OCR
Se você está construindo pipelines de documentos para qualquer pessoa com requisitos de residência de dados, manufatura multi-site, registros de saúde em sistemas hospitalares, documentos financeiros em entidades regionais, este artigo é um ponto de dados útil de que o tradeoff "treinar centralmente ou não treinar de todo" não é tão binário quanto parece.
Algumas conclusões concretas para qualquer pessoa avaliando OCR nesse tipo de ambiente:
- O pré-treinamento importa mais do que o mecanismo de federação em si. A parte inteligente do FedTR não é a média federada, que é basicamente padrão. A parte inteligente é recusar-se a iniciar o treinamento federado do zero. Se você está preso a dados isolados, a jogada de maior alavancagem geralmente é um modelo base de propósito geral robusto, não um algoritmo de agregação mais sofisticado.
- Não assuma que o aprendizado federado é um almoço grátis. O artigo é honesto ao afirmar que o FL simples tem desempenho inferior em conjuntos de dados pequenos e difíceis, o que coincide com o que muitos praticantes descobriram da maneira difícil. Se alguém vender para você "apenas federar" como solução para um problema de silos de dados, pergunte em que o modelo base foi pré-treinado.
- A precisão em nível de palavra é a métrica correta para exigir, não a de nível de caractere. Muito do marketing de OCR se apoia na precisão de caracteres porque é um número maior e mais atraente. Para qualquer processo downstream que parseie campos inteiros (códigos de lote, SKUs, datas), a precisão de caracteres pode esconder um modelo que é inútil na prática. 95,5% de precisão em palavras é um número genuinamente forte precisamente porque é o padrão mais difícil.
O que está faltando e por que você não deve extrapolar demais
O artigo testa os rótulos de cartuchos de tinta de uma única empresa. Esse é um benchmark real, específico e comercialmente relevante, mas trata-se de apenas uma categoria de produto, um conjunto de dados privado de um único artigo, e a configuração "heterogênea" ainda representa variação simulada dentro dos dados de uma única empresa, em vez de organizações verdadeiramente independentes com convenções de rotulagem drasticamente diferentes.
Também não há discussão sobre o custo de comunicação ou quantas rodadas federadas foram necessárias para a convergência, o que é crucial na prática: enviar atualizações de modelo de um lado para o outro entre três fábricas algumas vezes é aceitável, mas fazer isso entre trezentas unidades fabris (ou uma empresa verdadeiramente global) é um problema de infraestrutura inteiramente diferente. Além disso, não há comparação com outras combinações de aprendizado por transferência mais FL que surgiram em outros domínios, portanto, é difícil saber se a receita específica do FedTR é melhor do que as alternativas óbvias ou apenas a primeira que alguém tentou neste conjunto de dados.
Ainda assim, a direção é sólida e a lacuna entre o que é demonstrado aqui e uma implantação em produção é trabalho de engenharia normal, não uma lacuna de pesquisa. Em um espaço de IA para documentos onde muito do trabalho publicado nunca toca em um conjunto de dados real, privado e comercialmente sensível, testar em dados reais de controle de qualidade de cartuchos de tinta de um parceiro de manufatura real conta para algo. É a diferença entre um artigo que prova que uma técnica funciona em um benchmark e um que prova que ela sobrevive ao contato com o chão de fábrica.