Una fábrica que nunca comparte sus fotos, pero que aún así aprende a leer etiquetas
Basado en: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
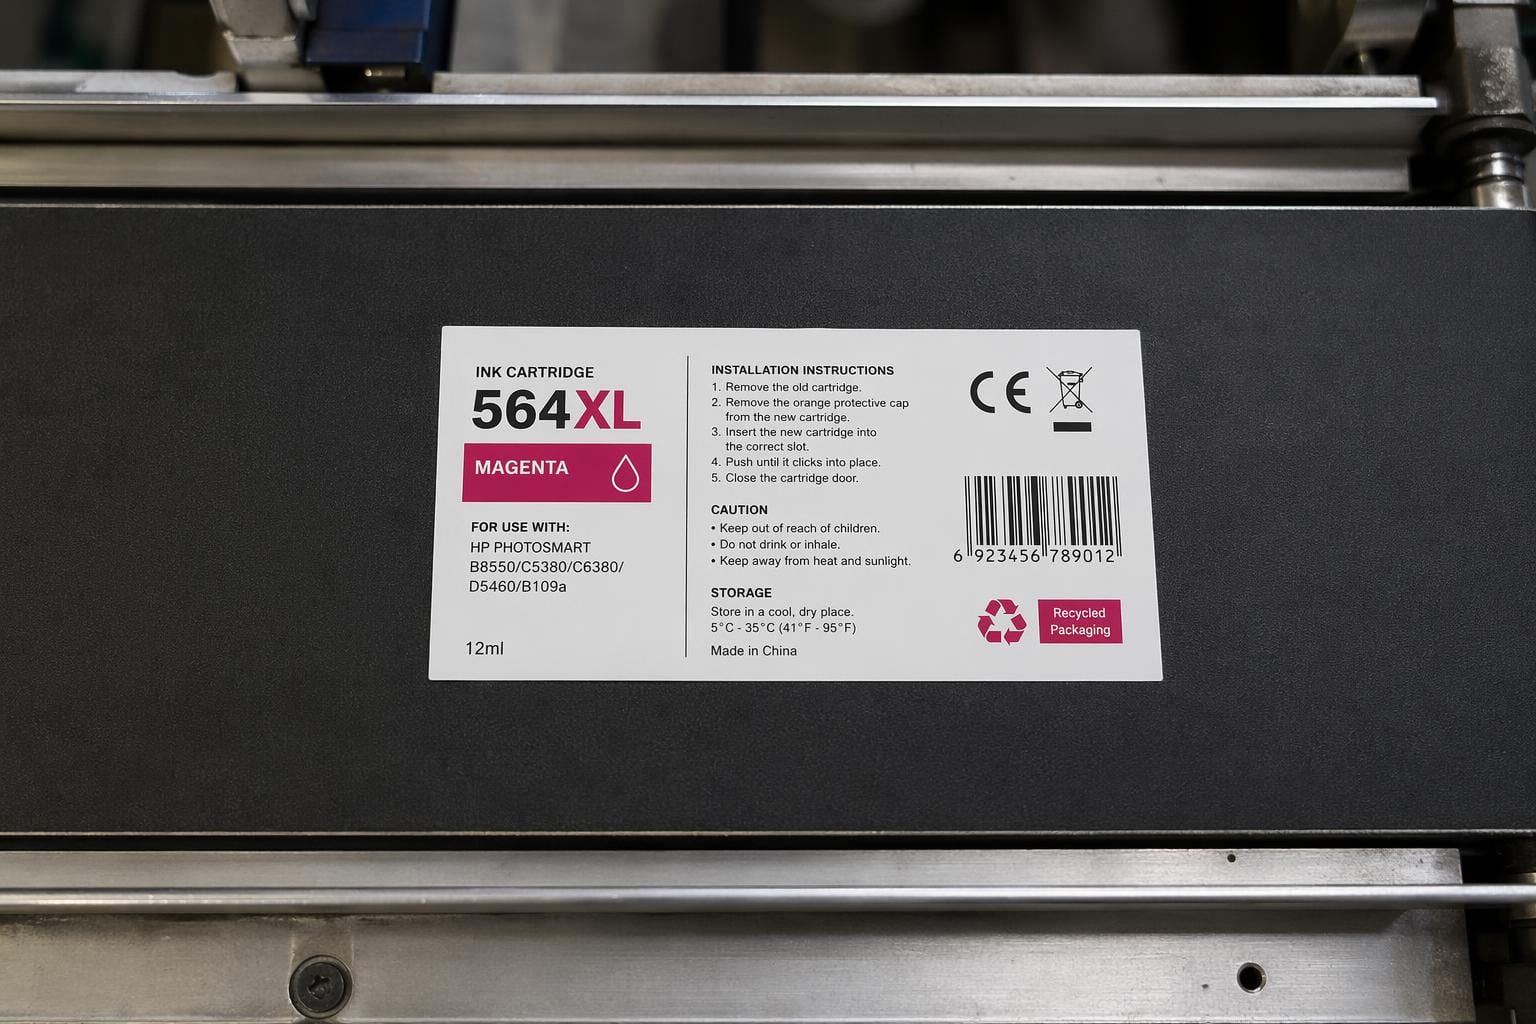
Imagina tres fábricas de cartuchos de tinta propiedad de la misma empresa, una en Shenzhen, otra en Penang y otra en Chennai. Cada una tiene cámaras en la línea de producción que fotografían las etiquetas mientras pasan, verificando si hay códigos de lote manchados, fechas de caducidad mal impresas, ese tipo de cosas. Cada fábrica tiene quizás unas pocas miles de imágenes etiquetadas de defectos. Ninguna puede enviar esas imágenes a un servidor compartido, porque las imágenes muestran diseños de etiquetas propietarios, números de lote vinculados a contratos con clientes y datos de control de calidad interno que nadie quiere que salgan de la planta.
Ese es el contexto detrás de FedTR, un nuevo artículo de un equipo que abarca la Universidad Tecnológica de Nanyang y socios de la industria. El problema que están resolviendo no es glamuroso. Es la situación poco glamorosa, pero extremadamente común, en la que necesitas un buen modelo de OCR pero los datos de entrenamiento están dispersos en sitios que legal o contractualmente no pueden agruparlos.
Por qué este problema es más difícil de lo que parece
El aprendizaje federado ya existe como respuesta al desafío de "entrenar con datos que no se pueden centralizar". La idea básica es la siguiente: en lugar de enviar los datos a un servidor central, se envía un modelo a cada sitio, se permite que se entrene localmente y luego se devuelven únicamente los pesos actualizados del modelo (no las imágenes) para promediarlos. Y se repite el proceso. Las fotos de la línea de producción de ninguna fábrica salen nunca de la fábrica.
La afirmación central del artículo es que el aprendizaje federado estándar falla específicamente en la inspección visual industrial, y vale la pena reflexionar sobre el porqué. Dos factores se combinan en tu contra simultáneamente:
- Los datos son escasos. Una fábrica que realiza control de calidad de etiquetas podría tener solo unas pocas miles de imágenes en total, no los millones que un modelo normalmente requiere. El aprendizaje federado intenta entrenar un modelo hacia un objetivo del tamaño de Chennai con una cantidad de datos del tamaño de Chennai.
- La tarea es compleja. No se trata simplemente de "¿hay un defecto, sí o no?". Se trata de reconocimiento de texto extremo a extremo: encontrar la región de texto en una etiqueta y luego leerla correctamente, carácter por carácter, código por código de lote. Esta es una tarea mucho menos indulgente que la clasificación binaria y necesita más señal para aprender adecuadamente.
La combinación de datos escasos y una tarea compleja es una mala combinación para cualquier método de aprendizaje profundo, federado o no. Promediar varios modelos subentrenados no produce un modelo bien entrenado. Solo produce un modelo subentrenado promediado.
La solución: aprovechar el conocimiento previo antes de federar
La respuesta de FedTR es no comenzar el entrenamiento federado con un modelo en blanco. En su lugar:
- Entrena el modelo primero en un conjunto de datos público, grande y genérico de reconocimiento de texto. Esto es aprendizaje por transferencia: el modelo aprende habilidades generales, como cómo se ve el texto, cómo están formadas las letras, cómo distinguir un "6" de un "8" manchado, a partir de datos que no tienen nada que ver con cartuchos de tinta.
- Solo después de este preentrenamiento, el modelo se envía a las fábricas individuales para un ajuste fino federado en sus conjuntos de datos pequeños, privados y reales.
La analogía que realmente funciona aquí es la contratación. No entrenas a un nuevo empleado para leer facturas dándole solo tres días de facturas en el trabajo y nada más. Contratas a alguien que ya sabe leer y luego le enseñas el formato específico de tus facturas. FedTR hace lo mismo: el conjunto de datos público enseña al modelo a leer en general, y el aprendizaje federado le enseña las fuentes, diseños y patrones de defectos específicos de tu fábrica.
Es una idea razonable y, francamente, no es radicalmente novedosa. La combinación de aprendizaje por transferencia y aprendizaje federado se ha probado en otros dominios. Lo que el artículo realmente aporta es demostrar que funciona y cuantificar qué tan bien lo hace en una tarea genuinamente difícil y comercialmente relevante: leer etiquetas llenas de defectos en cartuchos de tinta.
Qué probaron realmente y cuánto les costó
El equipo realizó experimentos con conjuntos de datos privados de cartuchos de tinta bajo dos condiciones:
- Homogénea: los datos de cada fábrica son estadísticamente similares entre sí (mismo estilo de etiqueta, tipos de defecto similares).
- Heterogénea: los datos de cada fábrica son diferentes (diseños de etiqueta distintos, distribuciones de defectos diferentes). Este es el caso mucho más difícil y realista para una empresa global con plantas que fabrican productos diferentes en distintos países.
FedTR alcanzó una precisión a nivel de palabra del 95,5 % en la configuración homogénea y del 94,2 % en la heterogénea. La precisión a nivel de palabra aquí significa que el modelo acertó la palabra completa, no solo la mayoría de los caracteres, lo cual es el estándar que realmente importa para algo como un código de lote: acertar 9 de 10 caracteres en "LOT4471X" es una lectura fallida, no un éxito del 90 %.
El número en el que vale la pena detenerse es lo pequeño que es el margen entre lo homogéneo y lo heterogéneo: 1,3 puntos porcentuales. El aprendizaje federado tiene un modo de fallo bien documentado donde el rendimiento se desploma cuando las distribuciones de datos de los clientes divergen (los investigadores llaman a esto el "problema no-IID", donde IID significa independiente e idénticamente distribuido, una forma elegante de decir "tus datos de entrenamiento no provienen todos de la misma distribución estadística"). Un margen pequeño aquí significa que la etapa de preentrenamiento con aprendizaje por transferencia está haciendo un trabajo real aislando al modelo de ese modo de fallo, no solo añadiendo una mejora marginal.
La otra cifra destacada: los resultados federados de FedTR son aproximadamente equivalentes al entrenamiento centralizado, es decir, entrenar un modelo con todos los datos agrupados en un solo lugar, lo cual no está permitido aquí pero sirve como techo teórico. Igualar ese techo sin agrupar ningún dato es todo el punto del ejercicio, y el artículo respalda la afirmación con cifras reales en lugar de solo afirmarla.
Por qué importa si estás construyendo o comprando OCR
Si estás construyendo pipelines de documentos para cualquier persona con requisitos de residencia de datos, manufactura multi-sitio, registros de salud a través de sistemas hospitalarios, documentos financieros a través de entidades regionales, este paper es un punto de datos útil de que el tradeoff de "entrenar centralmente o no entrenar en absoluto" no es tan binario como parece.
Algunas conclusiones concretas para cualquiera que esté evaluando OCR en este tipo de entorno:
- El pretraining importa más que el mecanismo de federación en sí. La parte ingeniosa de FedTR no es el promedio federado, que es mayormente estándar. La parte ingeniosa es negarse a comenzar el entrenamiento federado desde cero. Si estás atascado con datos en silos, el movimiento de mayor palanca suele ser un modelo base de propósito general fuerte, no un algoritmo de agregación más sofisticado.
- No asumas que el aprendizaje federado es una solución gratuita. El paper es honesto al decir que el FL simple tiene un rendimiento inferior en conjuntos de datos pequeños y difíciles, lo cual coincide con lo que muchos practicantes han descubierto de la manera difícil. Si alguien te vende "solo federar" como solución a un problema de silos de datos, pregunta en qué se preentrenó el modelo base.
- La precisión a nivel de palabra es la métrica correcta para exigir, no la de nivel de carácter. Gran parte del marketing de OCR se basa en la precisión de caracteres porque es un número más grande y mejor presentado. Para cualquier proceso downstream que analice campos completos (códigos de lote, SKUs, fechas), la precisión de caracteres puede ocultar un modelo que es inútil en la práctica. 95.5% de precisión a nivel de palabra es un número genuinamente fuerte precisamente porque es una barra más alta.
Qué falta y por qué no deberías sobreextrapolar
El artículo evalúa el modelo en las etiquetas de cartuchos de tinta de una sola empresa. Se trata de un punto de referencia real, específico y comercialmente relevante, pero corresponde a una única categoría de producto y a un conjunto de datos privado de un solo estudio. Además, la configuración "heterogénea" sigue siendo una variación simulada dentro de los datos de una misma empresa, en lugar de organizaciones verdaderamente independientes con convenciones de etiquetado radicalmente distintas.
Tampoco se aborda el costo de comunicación ni el número de rondas federadas necesarias para la convergencia, aspectos cruciales en la práctica: enviar actualizaciones del modelo de ida y vuelta entre tres fábricas unas cuantas veces es viable, pero hacerlo entre trescientas plantas (o en una empresa verdaderamente global) plantea un problema de infraestructura completamente diferente. Asimismo, no se realiza una comparación con otras combinaciones de aprendizaje por transferencia y aprendizaje federado (FL) que han surgido en otros dominios, por lo que resulta difícil determinar si la fórmula específica de FedTR es superior a las alternativas evidentes o simplemente la primera que se probó en este conjunto de datos.
No obstante, la dirección es correcta y la brecha entre lo demostrado aquí y una implementación en producción es trabajo de ingeniería habitual, no una laguna de investigación. En el ámbito de la IA para documentos, donde gran parte de la literatura publicada nunca interactúa con conjuntos de datos reales, privados y comercialmente sensibles, probar el modelo con datos reales de control de calidad de cartuchos de tinta de un socio manufacturero tiene su valor. Es la diferencia entre un artículo que demuestra que una técnica funciona en un punto de referencia y uno que demuestra que sobrevive al contacto con el suelo de una fábrica.