مصنع لا يشارك صوره أبداً، لكنه لا يزال يتعلم قراءة الملصقات
استنادًا إلى: FedTR: Federated Learning Framework with Transfer Learning for Industrial Visual Inspection — Vikash Sathiamoorthy, Shuo Huai, Hao Kong, Di Liu, Wendy Yong Yi Loy, Christian Makaya, Daren Ho, Ravi Subramaniam, Qian Lin, Weichen Liu
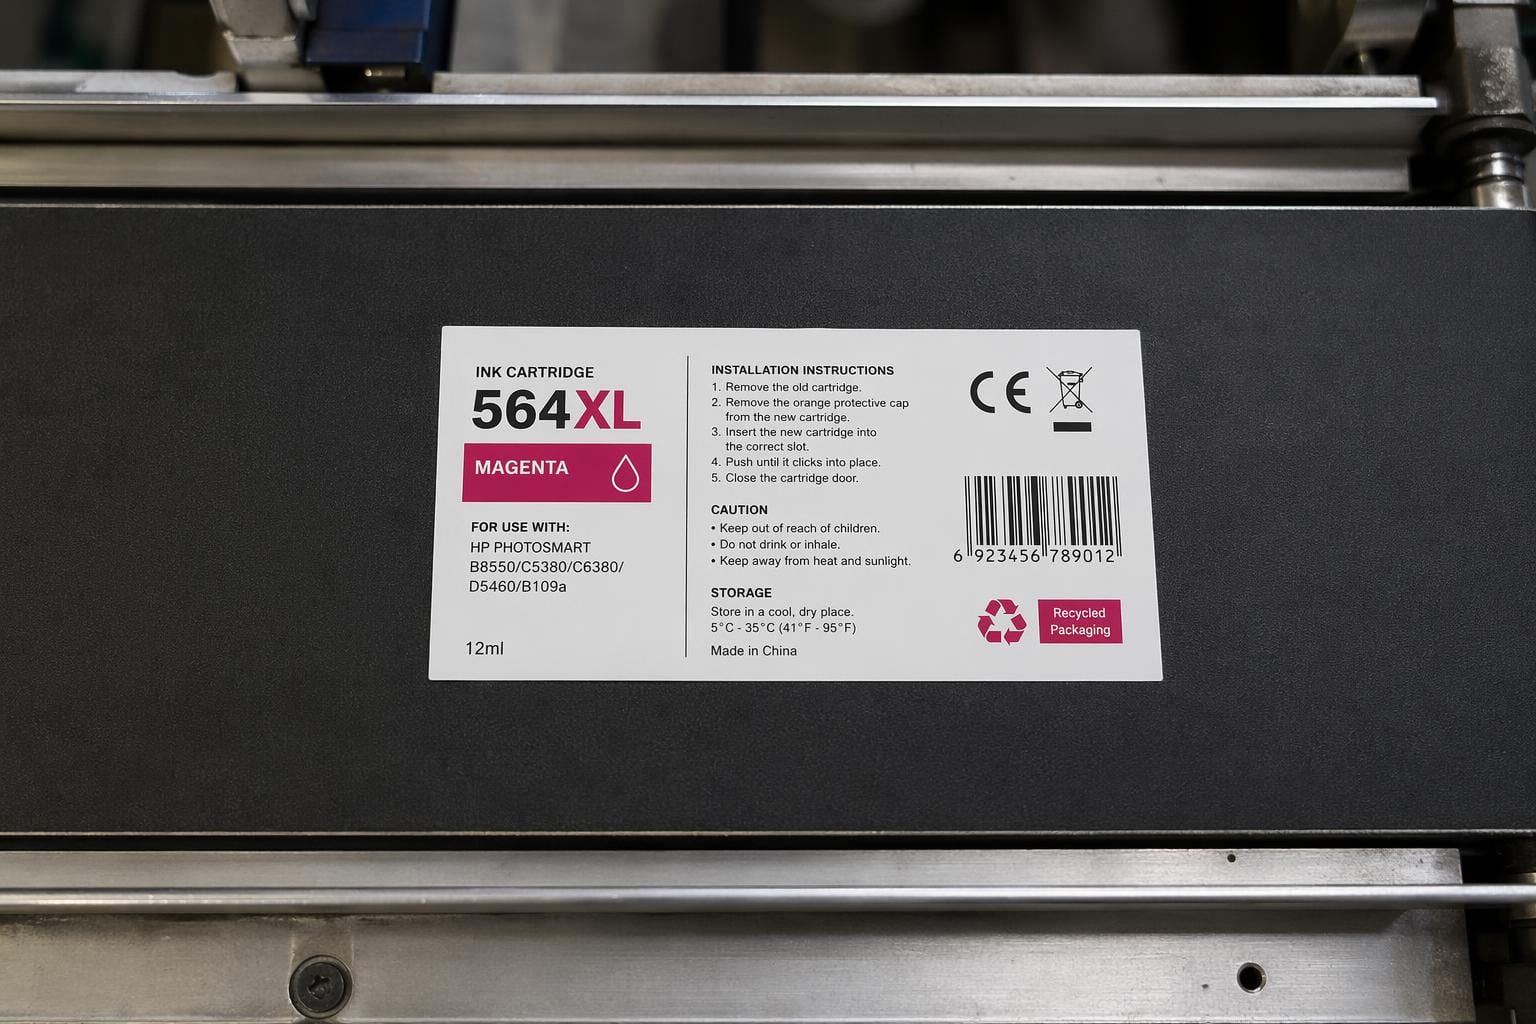
تخيل ثلاث مصانع لخرطوش الحبر مملوكة لنفس الشركة، واحدة في شينزن، وأخرى في بينانغ، والثالثة في تشيناي. تحتوي كل مصنع على كاميرات مثبتة على خط الإنتاج لتصوير الملصقات أثناء مرورها، للتحقق من وجود أكواد دفعة مشوشة أو تواريخ انتهاء صلاحية مطبوعة بشكل خاطئ، وما شابه ذلك. يمتلك كل مصنع بضعة آلاف من الصور الملصقة التي تظهر العيوب. ولا يمكن لأي من هذه المصانع إرسال هذه الصور إلى خادم مشترك، لأنها تعرض تصاميم ملصقات خاصة، وأرقام دفعات مرتبطة بعقود العملاء، وبيانات ضمان الجودة الداخلية التي لا يريد أحد خروجها من المبنى.
هذا هو السياق الذي ظهر فيه FedTR، وهو ورقة بحثية جديدة من فريق يمتد عبر جامعة نانيانغ للتكنولوجيا وشركاء من القطاع الصناعي. المشكلة التي يحلونها ليست رائعة. إنها الحالة غير الرائعة ولكن شائعة للغاية حيث تحتاج إلى نموذج OCR جيد، لكن بيانات التدريب موزعة عبر مواقع لا يمكنها قانونياً أو تعاقدياً تجميعها معاً.
لماذا هذه المشكلة أصعب مما تبدو عليه
توجد بالفعل تقنية "التعلم الاتحادي" (Federated Learning) كحل لمشكلة "التدريب على بيانات لا يمكن تركزها". الفكرة الأساسية هي: بدلاً من إرسال البيانات إلى خادم مركزي، يتم إرسال النموذج إلى كل موقع، والسماح له بالتدريب محلياً، ثم إرسال أوزان النموذج المحدثة فقط (وليس الصور) لدمجها معاً. ثم يتم تكرار العملية. لا تغادر صور خطوط الإنتاج في أي مصنع حدود المصنع أبداً.
الادعاء الأساسي للورقة البحثية هو أن التعلم الاتحادي التقليدي يفشل في مجال التفتيش البصري الصناعي تحديداً، ومن المفيد التوقف للتفكير في السبب. هناك عاملان يعملان ضدك في وقت واحد:
- البيانات صغيرة. قد يمتلك مصنع يقوم بمراقبة جودة الملصقات بضعة آلاف من الصور فقط، وليس الملايين التي يحتاجها النموذج عادةً. يقوم التعلم الاتحادي بتدريب نموذج على هدف بحجم تشيناي باستخدام كمية بيانات بحجم تشيناي.
- المهمة صعبة. هذه ليست مسألة "هل يوجد عيب، نعم أم لا". إنها التعرف النصي من البداية إلى النهاية: العثور على منطقة النص على الملصق، ثم قراءته بشكل صحيح، حرفاً بحرف، وكود دفعة بكود دفعة. هذه مهمة أقل تساهلاً من التصنيف الثنائي، وتحتاج إلى إشارة أكثر لتتعلم بشكل جيد.
البيانات الصغيرة والمهمة الصعبة هي مزيج سيء لأي طريقة تعلم عميق، سواء كانت اتحادية أم لا. دمج عدة نماذج غير مدربة بشكل كافٍ لا ينتج نموذجاً مدرباً بشكل جيد. إنه ينتج فقط نموذجاً غير مدرب بشكل كافٍ ومتوسط.
الحل: استعارة القوة قبل أن تُلحِق
جواب FedTR هو عدم بدء التدريب الموزع من نموذج فارغ. بدلاً من ذلك:
- قم بتدريب النموذج أولاً على مجموعة بيانات عامة كبيرة للتعرف العام على النصوص. هذا هو التعلم الانتقالي: يتعلم النموذج مهارات عامة، مثل كيف تبدو النصوص، وكيف تتشكل الحروف، وكيف يميز بين "6" و"8" مشوشة، من بيانات لا علاقة لها بخرطوشة الحبر.
- فقط بعد هذا التدريب المسبق، يتم إرسال النموذج إلى المصانع الفردية للتعديل الدقيق الموزع على مجموعات بياناتهم الصغيرة والخاصة والحقيقية.
التشبيه الذي ينطبق هنا هو التوظيف. لا تقوم بتدريب موظف جديد على قراءة الفواتير من خلال إعطائه ثلاثة أيام من الفواتير أثناء العمل ولا شيء آخر. تقوم بتوظيف شخص يعرف بالفعل كيفية القراءة، ثم تدرّبه على تنسيق الفواتير الخاص بك. يقوم FedTR بنفس الشيء: مجموعة البيانات العامة تعلم النموذج القراءة بشكل عام، والتعلم الموزع يعلمه الخطوط والتخطيطات وأنماط العيوب الخاصة بمصنعك.
إنها فكرة معقولة، وبصراحة، ليست فكرة جديدة تماماً. تم تجربة دمج التعلم الانتقالي والتعلم الموزع في مجالات أخرى. ما تقدمه الورقة حقاً هو إثبات أنها تعمل، وقياس مدى نجاحها، في مهمة صعبة حقاً وتجارية واقعية: قراءة الملصقات المليئة بالعيوب على خراطيش الحبر.
ما اختبروه فعلياً، وما كلفهم
أجرى الفريق تجارب على مجموعات بيانات خاصة بخراطيش الحبر تحت شرطين:
- متجانس (Homogeneous): تبدو بيانات كل مصنع متشابهة إحصائياً مع الأخرى (نفس نمط التسميات، أنواع عيوب متشابهة).
- غير متجانس (Heterogeneous): تبدو بيانات كل مصنع مختلفة (تصاميم تسميات مختلفة، توزيعات عيوب مختلفة). هذه هي الحالة الأصعب والأكثر واقعية لشركة عالمية لديها مصانع تنتج منتجات مختلفة في دول مختلفة.
حقق FedTR دقة بنسبة 95.5% على مستوى الكلمات في الإعداد المتجانس و94.2% في غير المتجانس. تعني دقة مستوى الكلمات هنا أن النموذج حصل على الكلمة كاملة بشكل صحيح، وليس مجرد معظم الأحرف، وهو المعيار الذي يهم فعلياً في شيء مثل رمز الدفعة: الحصول على 9 من 10 أحرف بشكل صحيح في "LOT4471X" هو قراءة فاشلة، وليس نجاحاً بنسبة 90%.
الرقم الذي يستحق التوقف عنده هو مدى ضيق الفجوة بين المتجانس وغير المتجانس: 1.3 نقطة مئوية. يتعلم الفيدرالي (Federated learning) لديه نمط فشل موثق جيداً حيث تنهار الأداء عندما تتباعد توزيعات بيانات العملاء (يسميه الباحثون "مشكلة non-IID"، حيث IID تعني مستقلة ومتطابقة التوزيع، وهي طريقة أنيقة لقول "بيانات التدريب الخاصة بك لا تأتي جميعها من نفس التوزيع الإحصائي"). تعني الفجوة الصغيرة هنا أن خطوة ما قبل التدريب بالتعلم بالنقل (transfer-learning) تقوم بعمل حقيقي في عزل النموذج عن هذا نمط الفشل، وليس مجرد إضافة دفعة هامشية.
الرقم الرئيسي الآخر: نتائج FedTR الفيدرالية تقارب تقريباً التدريب المركزي، مما يعني تدريب نموذج واحد على جميع البيانات المدمجة معاً في مكان واحد، وهو أمر غير مسموح به هنا ولكنه يخدم كسقف نظري. مطابقة هذا السقف دون دمج أي بيانات هو الهدف الكامل من التمرين، ويدعم الورقة هذا الادعاء بأرقام فعلية بدلاً من مجرد الادعاء به.
لماذا يهمك هذا الأمر إذا كنت تبني أو تشتري حلول التعرف الضوئي على الحروف (OCR)
إذا كنت تبني خطوط أنابيب معالجة المستندات لأي جهة لديها متطلبات تتعلق بسكنى البيانات (Data Residency)، أو تصنيع متعدد المواقع، أو سجلات صحية عبر أنظمة المستشفيات، أو وثائق مالية عبر كيانات إقليمية، فإن هذه الورقة تمثل نقطة بيانات مفيدة تُظهر أن المقايضة بين "التدريب المركزي أو عدم التدريب على الإطلاق" ليست ثنائية كما تبدو.
بعض النتائج العملية الملموسة لأي شخص يقيّم حلول التعرف الضوئي على الحروف في هذا النوع من البيئات:
- التدريب المسبق (Pretraining) أهم من آلية الفيدرالية نفسها. الجزء الذكي في FedTR ليس المتوسط الفيدرالي، فهو في الغالب قياسي. الجزء الذكي هو رفض بدء التدريب الفيدرالي من الصفر. إذا كنت عالقًا مع بيانات معزولة، فإن الخطوة ذات الأثر الأكبر هي عادةً نموذج أساسي قوي لغرض عام، وليس خوارزمية تجميع أكثر تعقيدًا.
- لا تفترض أن التعلم الفيدرالي وجبة مجانية. الورقة صادقة في أن التعلم الفيدرالي العادي يؤدي أداءً أقل على مجموعات البيانات الصغيرة والصعبة، وهو ما يتوافق مع ما وجدته العديد من الممارسات الصعبة. إذا عرض عليك شخص ما "فقط اجعله فيدراليًا" كحل لمشكلة عزل البيانات، اسأل عن ما تم تدريب النموذج الأساسي عليه مسبقًا.
- دقة مستوى الكلمة هي المقياس الصحيح للمطالبة به، وليس مستوى الحرف. يعتمد الكثير من تسويق التعرف الضوئي على الحروف على دقة الحرف لأنها رقم أكبر وأفضل مظهرًا. لأي شيء في المراحل التالية يحلل حقولًا كاملة (رموز الدفع، SKUs، التواريخ)، يمكن لدقة الحرف إخفاء نموذج عديم الفائدة عمليًا. دقة كلمة بنسبة 95.5% هي رقم قوي حقًا بالضبط لأنها الشريط الأصعب.
من الجدير بالذكر أن تعقيدات النصوص العربية، مثل طبيعتها المتصلة واتجاهها من اليمين إلى اليسار مع أشكال الحروف الحساسة للسياق، تجعل هذه المهمة أكثر صعوبة وتتطلب نماذج مدربة بعناية على مثل هذه الخصائص اللغوية الفريدة.
ما الذي ينقص، ولماذا لا ينبغي المبالغة في تعميم النتائج
اختبرت الورقة البحثية على ملصكات خرطوشة الحبر الخاصة بشركة واحدة. هذا معيار حقيقي ومحدد وذو دلالة تجارية، لكنه يقتصر على فئة منتج واحدة، ومجموعة بيانات خاصة بورقة بحثية واحدة، وإعداد "غير المتجانس" لا يزال يمثل تبايناً محاكياً ضمن بيانات شركة واحدة بدلاً من منظمات مستقلة حقاً ذات تقاليد مختلفة تماماً في وضع الملصقات.
كما لا يوجد أي نقاش حول تكلفة الاتصال أو عدد جولات التعلم الاتحادي (Federated Rounds) التي استغرقها التقارب، وهو أمر بالغ الأهمية في الممارسة العملية: إرسال تحديثات النموذج ذهاباً وإياباً بين ثلاث مصانع بضع مرات أمر مقبول، لكن فعل ذلك بين ثلاثمائة مصنع (أو شركة عالمية حقيقية) يمثل مشكلة بنية تحتية مختلفة تماماً. ولا يوجد أي مقارنة مع مجموعات أخرى من التعلم بالنقل والتعلم الاتحادي التي ظهرت في مجالات أخرى، لذا من الصعب معرفة ما إذا كانت وصفة FedTR المحددة أفضل من البدائل الواضحة أم أنها مجرد الأولى التي جربها أحد على هذه المجموعة من البيانات.
ومع ذلك، فإن الاتجاه سليم، والفجوة بين ما تم عرضه هنا والنشر في بيئة إنتاجية هي عمل هندسي عادي، وليس فجوة بحثية. في مجال ذكاء المستندات، حيث لا يلامس الكثير من الأعمال المنشورة أبداً مجموعة بيانات حقيقية وخاصة وحساسة تجارياً، فإن الاختبار على بيانات ضمان الجودة الفعلية لخرطوشة الحبر من شريك تصنيع حقيقي يعني شيئاً. إنه الفرق بين ورقة تثبت أن تقنية ما تعمل على معيار، وأخرى تثبت أنها تنجو من التلامس مع أرضية المصنع.