ドキュメントを撮影しても、なぜほとんどのOCRモデルが壊れてしまうのか
元論文: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
今すぐスマートフォンを取り出して、机の上にあるレシートを撮影してみましょう。スキャンではなく、経費精算や税金アプリ用にやるような、普通の撮影です。結果を見てみましょう。紙の端が少し丸まっていて、レンズに近い角と遠い角があり、折り目付近の文字は直線から少しずれています。あなたの目には何も壊れているようには見えません。しかし、ほとんどのOCRシステムにとっては、それは地雷原です。
「ラボでスキャンされた文書」と「現実世界で撮影された文書」の間のギャップは、新しい論文であるNaviDC-OCRが正面から取り組む問題です。この名前は「デジタルとカメラ撮影された文書間のナビゲーションによる文書解析」を意味し、チーム(所属に基づくと中国のAIラボの研究者たち)は、文書が平らで完璧に照らされている状態から外れた瞬間に静かに劣化するのではなく、両方のケースをうまく処理できる1つのモデルを構築しました。
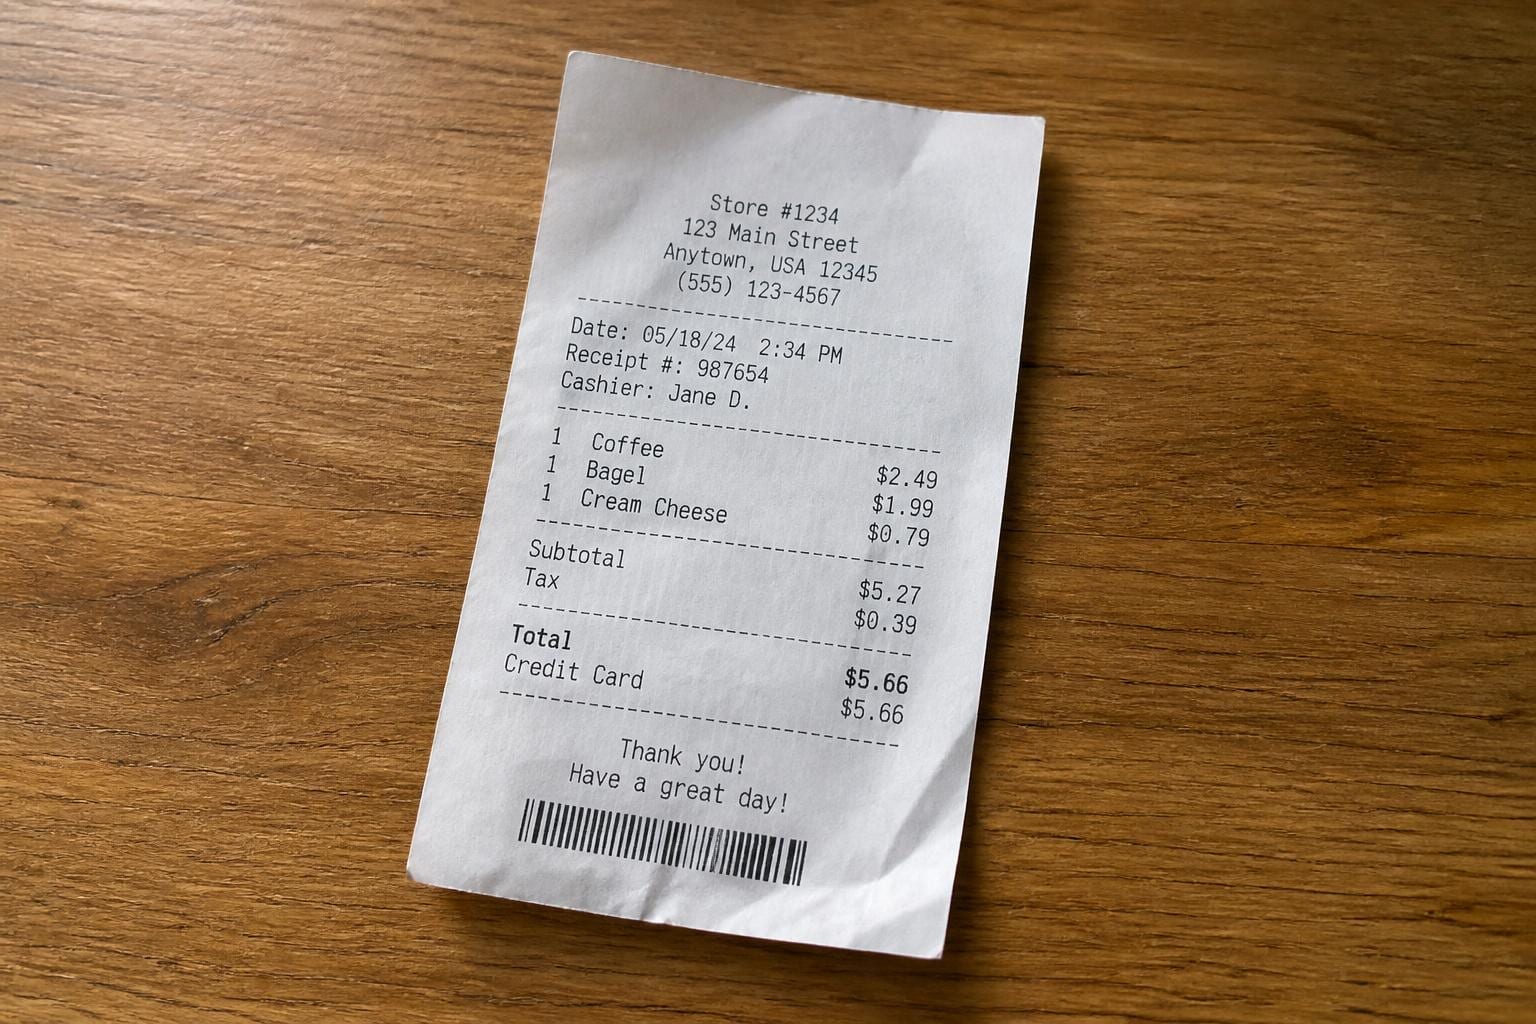
ドキュメントパーサーの構築方法2つ、そしてそれぞれの落とし穴
コンピュータが実際に活用できる構造化されたテキスト、表、数式へページ画像を変換する、いわゆる現代のドキュメント解析のタスクは、主に2つのアプローチのいずれかに従って行われます。
1つ目は、論文で「デカップル(分離)アプローチ」と呼ばれるものです。まずレイアウト解析を実行し、テキストブロック、表、図表を特定してそれらに矩形を引きます。その後、それぞれの矩形を認識モデルに入力して実際のコンテンツを抽出します。これは役割分担が明確で、フラットなスキャン画像が入力される場合にはよく機能します。しかし、落とし穴はカメラで撮影した写真の場合に現れます。ページが歪んでいたり、傾いていたり、部分的に影がかかっていると、レイアウト検出器が誤った矩形を描いてしまい、その誤りはすべての下流の処理に継承されます。わずかに湾曲した表の行が2つの矩形に切り取られたり、背表紙の周りに曲がった段落が間違った箇所で分割されたりします。最初のステップで幾何学的構造を誤ると、その後の処理では完全に回復させることはできません。
2つ目のアプローチはエンドツーエンド方式です。明示的なレイアウト検出をスキップし、単一のビジョン・ランゲージモデル(VLM:画像を入力としてテキストを生成するニューラルネットワークで、現代のチャットボットの画像理解機能の背後にあるモデルと同じファミリー)にページ全体を読ませ、直接構造化された出力を生成させます。これにより、誤りの連鎖問題を回避できますが、別の問題と引き換えになります。高解像度では、これらのモデルは冗長になりがちです。行を繰り返したり、ページに存在しないコンテンツを捏造したり(ハルシネーション)、密集したレイアウトの中でどこにいるのかを見失ったりします。インラインの数式と表を含む2カラムの論文のフルページをモデルに入力しても、どのセクションがどこで終わり、次のセクションがどこから始まるのかを常に正しく認識できるとは限りません。
これらの両方の失敗モードは、同じ根本原因から生じます。ページ上のテキストは単なる文字列ではなく、幾何学的構造の中に配置された文字列であり、その構造は現実の歪み(傾き、影、湾曲など)が入り込むと、読み取りが難しくなります。
モデルに「歪み」の実際の姿を教える
NaviDC-OCRの最初の改善点は、論文で「変形認識学習(deformation-aware learning)」と称されるものです。このアイデアは、モデルが幾何学的な歪み、湾曲、傾き、透視歪みなどを明示的に認識できるように訓練することです。これらは、フラットベッドスキャナーではなくカメラ写真によって生じる種類の歪みであり、単に十分な数の写真を見せることでモデルが副次的に学習することを期待するのではなく、直接的に学習させるアプローチです。
ガラス板の下に平らに置かれた印刷ページしか読んだことのない人、と、バスの中で奇妙な角度で持った本を何年も読んできた人の違いを考えてみましょう。後者の人は、「この線は実際にはまっすぐで、ページの湾曲の仕方によって曲がって見えるだけだ」という直観を築いています。NaviDC-OCRは、偶然に任せるのではなく、この種の事前知識を直接組み込もうとしています。
2つ目の要素は、複雑なレイアウトに対する適応的サンプリング機構です。高解像度のドキュメント画像を詳細に処理するのはコストがかかるため、多くのVLMはモデルに画像を入力する前に、画像をダウンサンプリングまたはタイル分割します。一様なグリッドは、密集した表と広い余白を同じように扱うため、空白部分に解像度を無駄遣いし、実際に必要な部分に解像度が不足します。適応的サンプリングは、視覚的に複雑な領域(表、数式、狭い多段組テキストなど)にはより多くの注意を配分し、単純な領域には少ない注意を配分します。これはレポートをさっと読むことと視覚的に同等です。12ページに埋もれたスプレッドシートと同じ速度で余白を読むわけではありません。
数式や表は、単に形が不規則なテキストではない
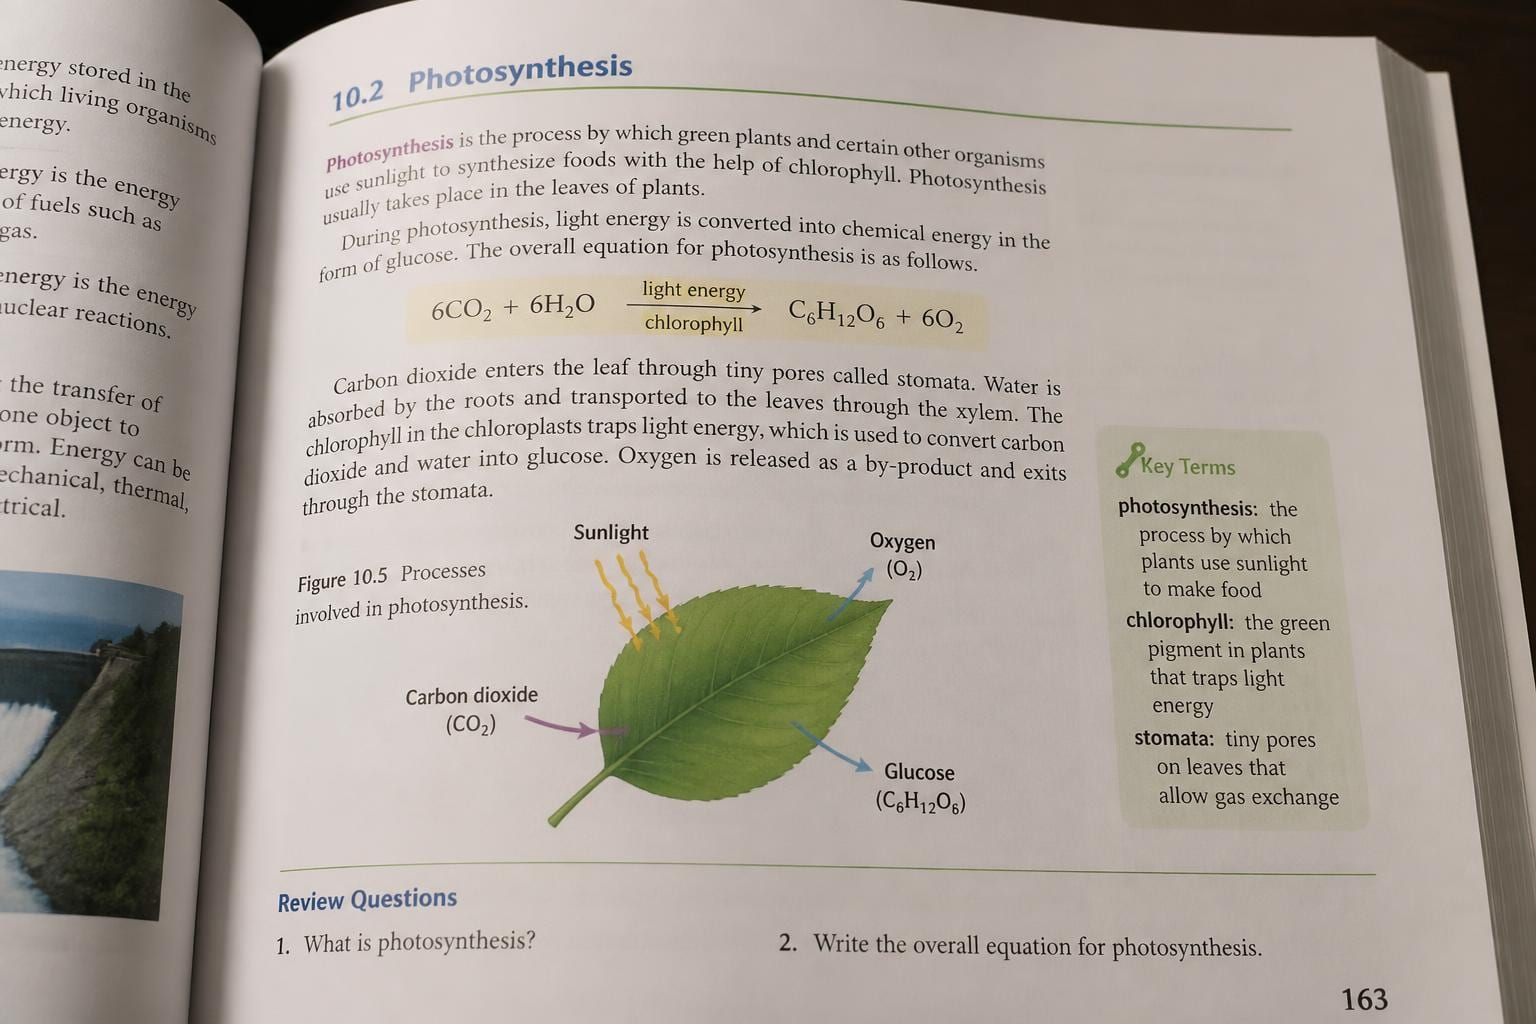
3つ目の貢献は、エンドツーエンドのOCRシステムをしばしば混乱させる課題に対処しています。それは、数式や表が通常の文章(prose)ではないという点です。数式には文法のようなものがあり、記号の配置が意味を符号化しています。例えば、分数線と上付き文字は構造的に異なる意味を持ちます。表には行、列、結合セルがあり、これらは単なる文字の並びではなく、値同士の関係性を定義します。
主に流れるようなテキストで学習されたモデルは、これらを「読み取りにくいテキスト」として扱い、混乱すると一見すると妥当に見えるが実際には無意味な出力を生成しがちです。指数の誤り、小数点のズレ、隣接するセルに気づかれないほど溶け込んでしまった表のセルなどがその例です。NaviDC-OCRの解決策は、「コンテンツと構造の分離学習」です。モデルに、構造(これは4×6の表である、これはこの分子と分母を持つ分数である)とコンテンツ(実際の文字が何か)を別々に推論させるように学習させます。両者を1つの生成タスクに押し込むのではなく、このアプローチは「この建物の形状は何か」と「入口の看板に何と書かれているか」を同時に1回の見通しで答えさせるのではなく、それぞれを分けて処理することに少し似ています。
ベンチマークの数値が実際に示していること
本論文では、3つのベンチマークでのスコアが報告されています。OmniDocBench v1.6で96.87、Wild-OmniDocBenchで88.53、PureDocBenchで78.41です。また、ドキュメントおよび科学画像の解析に関する国際競技会であるICDAR 2026 Sci-ImageMiner Challengeで1位を獲得したとも主張しています。
OmniDocBenchは、学術論文、教科書、試験用紙、財務報告書など、幅広い種類のドキュメントを網羅する確立されたベンチマークです。レイアウト検出とテキスト認識の両方を総合的に評価します。ここで90代後半のスコアを記録することは、モデルが、多くのパーサーが最適化されているトレーニング分布に近い種類のドキュメントで非常に良好なパフォーマンスを発揮していることを意味します。
興味深いのは、Wild-OmniDocBenchで88.53へとスコアが低下している点です。名称と、カメラ撮影されたドキュメントに焦点を当てているという論文の主張から判断すると、これはほぼ間違いなく、より困難な実世界の写真版ベンチマークです。つまり、レイアウトパイプラインが苦手とする、丸まったレシート、斜めから撮影された本のページ、不均一な照明などの条件が想定されています。クリーンなベンチマークと「ワイルド」なベンチマークの間に8ポイントの差があることは、論文の要約にある見出しの数値では伝わらない重要な示唆を与えてくれます。すなわち、この問題のために特別に構築されたモデルであっても、入力データが複雑になると依然として性能が低下するということです。これは論文を貶めるものではなく、カメラ撮影ケースが実際にはどれほど困難であるかを示す正直なシグナルです。ベンダーがスキャンされたドキュメントのベンチマークのみを根拠に「人間レベルのOCR」を謳う際に、この点は常に念頭に置くべきでしょう。
PureDocBenchについては、要約だけでは完全に説明がつきません。名称からすると、歪みのないクリーンなドキュメントを想定しているように思えるため、その解釈が正しい場合、スコアが低い(78.43で、「ワイルド」ベンチマークよりも低い)ことは真に驚くべきことです。PureDocBenchが、歪みではなく、より高密度な科学系レイアウト、より複雑な数式や表の内容といった全く異なる種類の難易度を対象としている可能性もあります。論文全体のベンチマーク説明を目にしない限り、この数値は確定した事実として扱うのではなく、さらに調査すべきフラグとして捉え、結論を導き出す前に、実際にどのようなドキュメントタイプで構成されているのかを確認したいところです。
OCRパイプラインの構築や選定において、なぜこれが重要なのか
ユーザーからドキュメントを取り込む製品を構築している場合、例えばスマートフォンで撮影された請求書、斜めからスキャンされた身分証明書、モバイルアプリを通じて提出されたレシートなどが対象であれば、本論文で述べられている「分離型(decoupled)」と「エンドツーエンド」の違いは単なる学問的な議論ではありません。これは、おそらくすでに見たことのある失敗モードを説明するものです。すなわち、クリーンなPDFのテストスイートでは完璧に動作するパーサーが、実際のユーザーがスマートフォンからの写真をアップロードし始めた瞬間に崩壊してしまう現象です。
いくつかの実践的な教訓を挙げます:
- スキャンデータだけでなく、カメラ撮影画像でもテストを行う。 評価セットがすべてフラットベッドスキャンやクリーンなPDFエクスポートで構成されている場合、あなたは「簡単なケース」のみを測定していることになります。本論文におけるOmniDocBenchとWild-OmniDocBenchの間のギャップ(96.87対88.53)は、現実世界の入力においてどれだけのパフォーマンス低下を予想すべきかを示す合理的な指標となります。
- レイアウトエラーの連鎖に特に注意する。 分離型パイプライン(レイアウト検出、その後認識)を使用している場合、読み取り不能なテーブルや欠落した段落は、しばしば認識エラーという仮面を被ったレイアウトのバグです。テキストをデバッグする前に、バウンディングボックスをデバッグしてください。
- 数式やテーブルが多いドキュメントは、目視確認以上の厳密な検証が必要。 モデルは、一見すると正しく見えるテーブルを生成する可能性がありますが、行と列のマッピングが微妙に間違っていることがあります。これはまさにコンテンツと構造の分離が削減しようとする失敗です。ユースケースに財務テーブルや科学の数式が含まれる場合は、読みやすさだけでなく構造をサンプリングチェックしてください。
- 単一の論文からのベンチマーク数値は出発点であり、購入決定ではありません。 本リリースノートには、トレーニングデータの構成、推論コスト、モデルサイズといった、レイテンシ制約のある本番システムでこの種のモデルと軽量パイプラインのどちらを選ぶかを決める際に非常に重要な情報が記載されていません。
なお、日本語は漢字と仮名を混在させ、縦書きという独特のレイアウトを採用するため、英語のみを対象とした本論文や縦書きテキストを無視するモデルでは、日本語読者にとって実用的なOCR性能が十分に評価されていない点に留意が必要です。
まだ不明な点
この論文の抄録には、モデルのサイズ、推論速度、あるいは重みやコードの公開予定についての言及がありません。これらは、すでに利用可能で小さくコストの低いOCRシステムとの比較検討において極めて重要です。1ページあたり数秒を要し、高性能GPUを必要とする最先端のVLM(ビジョン言語モデル)と、汎用ハードウェアでスケールして実行できるシステムとは、全く異なる提案です。
また、ベンチマーク駆動型の論文には常に以下の注意点があります。最先端の主張は、著者が選定したベンチマークに対して測定されるものであり、それらのベンチマークがどのように構築されたか、あるいはあなたが関心のある特定の文書タイプを適切に反映しているかは必ずしも明確ではありません。特にPureDocBenchの結果については、これらの数値を一般化能力に関する最終的な判断材料とする前に、より詳細な検討が必要です。
それでも、このアイデアの中核は妥当であり、具体的な数値が検証でどの程度維持されるかに関わらず注目する価値があります。文書解析は長年にわたり、きれいで平坦、かつ良好な照明条件の入力に対して最適化されてきましたが、現実世界の文書キャプチャの多くは、不完全な照明下でスマートフォンカメラを通じて行われています。幾何学的歪みを前処理で除去するものではなく、学習すべき対象として扱うモデルは、正しい問題に焦点を当てています。それが実際にあなたのパイプラインに採用されるモデルかどうかは別問題ですが、ベンチマーク表の数値を鵜呑みにするのではなく、ご自身で手元にある粗雑で現実的な撮影済み文書を使ってテストしてみる価値は十分にあります。