لماذا لا يزال تصوير المستندات يربك معظم نماذج التعرف الضوئي على الحروف (OCR)؟
استنادًا إلى: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
أخرج هاتفك الآن والتقط صورة لإيصال ملقى على مكتبك. لا تمسحه ضوئياً، بل التقط له صورة عادية، تماماً كما تفعل عند إعداد تقرير المصاريف أو استخدام تطبيق الضرائب. انظر إلى النتيجة: الورقة ملتفة قليلاً عند الأطراف، وأحد الأركان أقرب إلى العدسة من الآخر، والنص القريب من الثنية ينحني بدرجة تكفي لكسر استقامة السطر. بالنسبة لعينيك، لا يبدو في الصورة أي عيب، لكن بالنسبة لمعظم أنظمة التعرف الضوئي على الحروف (OCR)، فإنها أشبه بحقل ألغام.
هذه الفجوة بين «المستندات الممسوحة ضوئياً في بيئة مختبرية» و«المستندات الملتقطة بالكاميرا في الواقع العملي» هي المشكلة التي تتصدى لها بوضوح ورقة بحثية جديدة بعنوان NaviDC-OCR. والاسم اختصار لـ Navigating Document Parsing Across Digital and Camera-Captured Documents (استكشاف تحليل المستندات عبر الوثائق الرقمية والملتقطة بالكاميرا)، وقد طوّر الفريق البحثي (المكون من باحثين ينتمون إلى عدة مختبرات ذكاء اصطناعي صينية وفقاً لبيانات الانتساب) نموذجاً واحداً مصمماً للتعامل مع الحالتين بكفاءة، بدلاً من التراجع الصامت في الأداء بمجرد أن يفقد المستند استواءه وإضاءته المثالية.
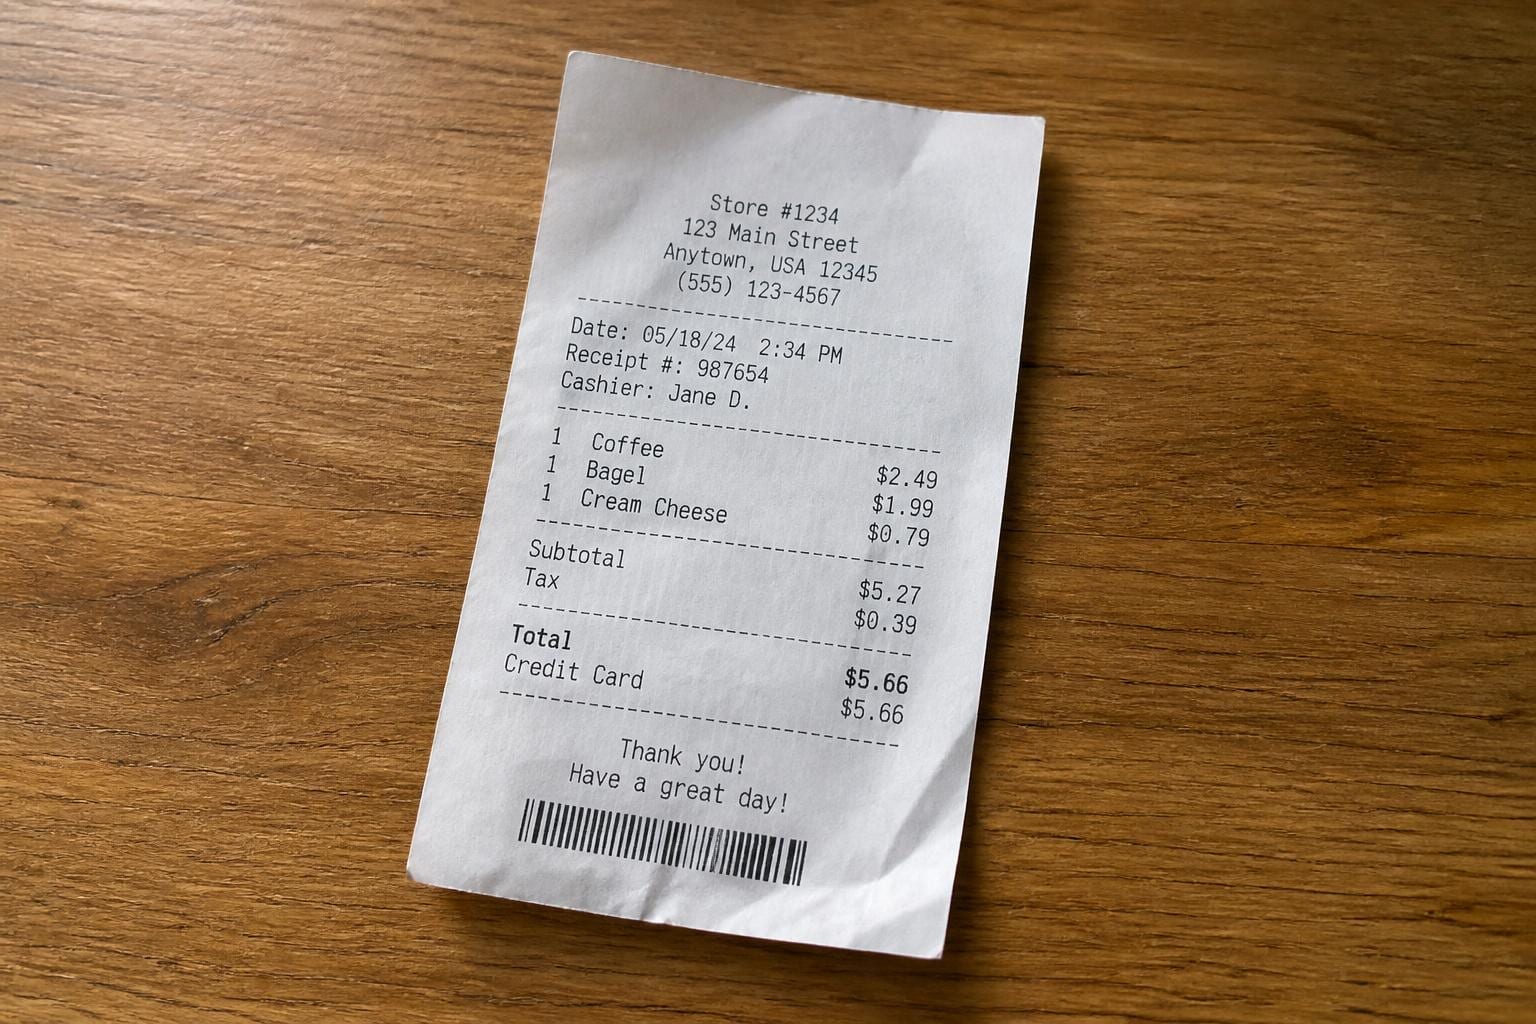
طريقتان لبناء محلل مستندات، ولماذا تنطوي كلتاهما على مأزق
يتبع تحليل المستندات الحديث — وهو مهمة تحويل صورة الصفحة إلى نص وجداول ومعادلات مهيكلة يمكن للحاسوب استخدامها فعلياً — أحد منهجين رئيسيين في الغالب.
المنهج الأول هو ما تطلق عليه الورقة البحثية «النهج المنفصل» (decoupled approach). وفيه تبدأ بتحليل التخطيط (layout analysis) أولاً: تحديد كتل النصوص والجداول والأشكال، ورسم مربعات إحاطة حولها، ثم تغذية كل مربع لنموذج تعرّف لاستخراج المحتوى الفعلي. إنه تقسيم أنيق للمهام، ويعمل جيداً عندما يكون الإدخال مسحاً ضوئياً مسطحاً. لكن المأزق يظهر جلياً مع صور الكاميرا؛ فإذا كانت الصفحة ملتوية أو مائلة أو واقعة جزئياً في الظل، يرسم كاشف التخطيط مربعات خاطئة، وترث كل خطوة لاحقة هذا الخطأ. فقد ينقسم صف جدول منحنٍ قليلاً إلى مربعين منفصلين، أو تنشطر فقرة تلتف حول كعب الكتاب في موضع خاطئ. وإذا أخطأت في تقدير الهندسة البصرية في الخطوة الأولى، فلن يتمكن أي شيء بعدها من التعافي التام من هذا الخلل.
أما المنهج الثاني فهو النهج الشامل من البداية إلى النهاية (end-to-end): حيث يتم تخطي الكشف الصريح عن التخطيط، والاعتماد على نموذج لغة ورؤية موحد (VLM — وهو شبكة عصبية تستقبل صورة وتنتج نصاً، من نفس عائلة النماذج التي تقف خلف قدرات فهم الصور في روبوتات الدردشة الحديثة) لقراءة الصفحة بأكملها وتوليد مخرجات مهيكلة مباشرة. يتفادى هذا النهج معضلة توالي الأخطاء التراكمية، لكنه يستبدلها بمشكلة أخرى؛ فعند التعامل مع الدقة العالية، تميل هذه النماذج إلى الاستطراد والخلط: مثل تكرار السطور، أو اختلاق محتوى غير موجود في الصفحة (الهلوسة / hallucination)، أو فقدان تتبع موقعها الحالي داخل تخطيط كثيف. فإذا أطعمت النموذج صفحة كاملة من ورقة بحثية مقسمة إلى عمودين وتحتوي على معادلة مضمنة وجدول، فلن يدرك دائماً أين ينتهي قسم وأين يبدأ القسم التالي.
ينبع كلا نمطي الفشل من نفس السبب الجذري: فالنص الموجود على الصفحة ليس مجرد محارف متتالية، بل هو محارف تقع داخل بنية هندسية محددة، وتزداد قراءة هذه البنية صعوبة بمجرد أن تتدخل تعقيدات الواقع الحقيقي وتشوهاتها فيها.
تعليم النموذج المعنى الفعلي لمفهوم «التشوه والانحناء»
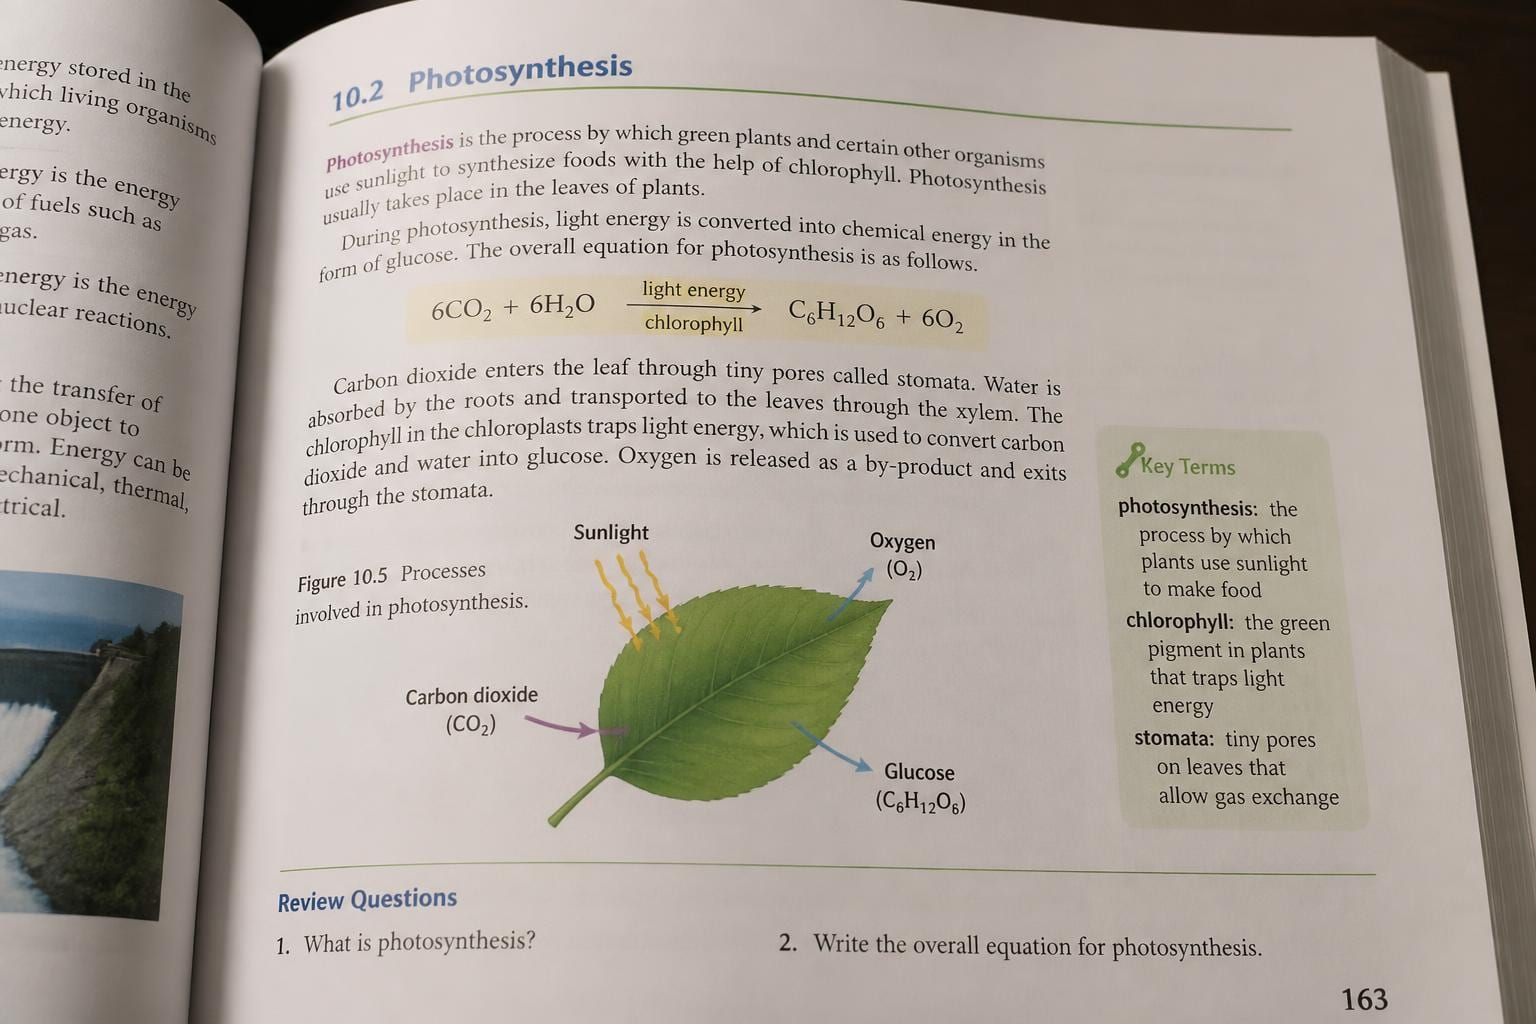
الحل الأول الذي يقدمه NaviDC-OCR هو ما تصفه الورقة بـ «التعلم الواعي بالتشوهات» (deformation-aware learning). وتتلخص الفكرة في تدريب النموذج بشكل صريح على إدراك التشوهات الهندسية، والالتواء، والميلان، وانحراف المنظور (perspective skew) — وهي التأثيرات التي تنتج عن تصوير الكاميرا ولا تظهر أبداً في الماسحات الضوئية المسطحة — بدلاً من الاكتفاء بالأمل في أن يكتسب النموذج هذا الإدراك تلقائياً كأثر جانبي لرؤية كمية كافية من الصور.
تأمل الفرق بين شخص لم يقرأ طوال حياته إلا صفحات مطبوعة وموضوعة بشكل مسطح تحت لوح زجاجي، وآخر أمضى سنوات يقرأ كتباً بزوايا غريبة داخل حافلة متحركة. لقد كوّن الشخص الثاني حدساً يخبره بأن «هذا السطر مستقيم في الأصل، ولكنه يبدو منحنياً بسبب طريقة ثني الصفحة». هذا هو نوع المعرفة القبلية (prior) التي يحاول NaviDC-OCR دمجها في النموذج مباشرة، بدلاً من تركها للصدفة.
أما الركيزة الثانية فهي آلية «أخذ العينات التكيفي» (adaptive sampling) للتخطيطات المعقدة. فمعالجة صور المستندات عالية الدقة بكامل تفاصيلها عملية مكلفة حوسبياً، ولذا تلجأ معظم نماذج VLM إلى خفض الدقة أو تقسيم الصورة إلى مربعات شبكية قبل إدخالها إلى النموذج. وتعامل الشبكة المنتظمة الجدول الكثيف بنفس الطريقة التي تعامل بها الهامش العريض، مما يهدر دقة المعالجة على المساحات الفارغة ويحرم الأجزاء التي تحتاج فعلياً إلى دقة أعلى. في المقابل، توزع آلية أخذ العينات التكيفي قدراً أكبر من الانتباه على المناطق المعقدة بصرياً — كالجداول والمعادلات والنصوص المتعددة الأعمدة والمزدحمة — وتمنح قدراً أقل للمناطق البسيطة. إنه المعادل البصري للتصفح السريع للتقرير: فأنت لا تقرأ الفراغات البيضاء بنفس التركيز الذي تقرأ به جدول البيانات المدرج في الصفحة 12.
المعادلات والجداول ليست مجرد نصوص ذات أشكال غير معتادة
تعالج المساهمة الثالثة نقطة تعثر شائعة في العديد من أنظمة التعرف الضوئي الشاملة (end-to-end OCR): وهي أن المعادلات والجداول ليست نصوصاً نثرية عادية. فالمعادلة تمتلك قواعد بنائية خاصة، بمعنى أن ترتيب الرموز يشفّر المعنى؛ فشرطة الكسر تعني بنيوياً شيئاً مختلفاً تماماً عن الأس المرتفع (superscript). والجدول يتألف من صفوف وأعمدة وخلايا مدمجة تحدد العلاقات بين القيم، وليس مجرد تسلسل عشوائي من المحارف.
تميل النماذج التي دُرّبت في الغالب على نصوص سردية متصلة إلى معاملة هذه العناصر كنصوص يصعب قراءتها فحسب، فتنتج عبثاً يبدو ظاهرياً معقولاً عند ارتباكها: أساً خاطئاً، أو فاصلة عشرية مزاحة عن مكانها، أو خلية جدول تندمج خلسة في الخلية المجاورة لها. وكان رد NaviDC-OCR على ذلك هو «التعلم بفصل المحتوى عن البنية» (content-structure decoupled learning): أي تدريب النموذج على التفكير بشكل منفصل في البنية الهيكلية (هذا جدول بأبعاد 4x6، وهذا كسر يتكون من هذا البسط وهذا المقام) وفي المحتوى (ما هي المحارف الفعلية)، بدلاً من دمج المهمتين في عملية توليد واحدة. إنه يشبه إلى حد ما الفصل بين «ما هو شكل هذا المبنى؟» و«ما هو المكتوب على اللافتة الأمامية؟»، بدلاً من مطالبة نظرة واحدة خاطفة بالإجابة عن كلا السؤالين معاً.
ما تكشفه أرقام الاختبارات المعيارية في الواقع
تسجل الورقة البحثية نتائج على ثلاثة اختبارات معيارية: 96.87 على OmniDocBench v1.6، و88.53 على Wild-OmniDocBench، و78.41 على PureDocBench. كما تدعي الحصول على المركز الأول في مسابقة ICDAR 2026 Sci-ImageMiner Challenge، وهو مسار منافسة دولي مخصص لتحليل المستندات والصور العلمية.
يُعد OmniDocBench مقياساً معيارياً راسخاً يغطي مزيجاً واسعاً من أنواع المستندات: الأوراق الأكاديمية، والكتب المدرسية، وأوراق الامتحانات، والتقارير المالية، ويقيّم كلاً من كشف التخطيط والتعرف على النص معاً. وتحقيق درجة في أواخر التسعينيات هناك يعني أن أداء النموذج متميز جداً على نوعية المستندات القريبة من توزيع بيانات التدريب التي صُممت معظم أدوات التحليل لتحقيق أقصى كفاءة عليها.
الرقم المثير للاهتمام حقاً هو التراجع إلى 88.53 على Wild-OmniDocBench. بالنظر إلى الاسم وتركيز الورقة المعلن على المستندات الملتقطة بالكاميرا، فهذا يمثل على الأرجح النسخة الأصعب المعتمدة على صور العالم الحقيقي: الإيصالات المتجعدة، وصفحات الكتب المصورة بزوايا مائلة، والإضاءة غير المتجانسة التي تعجز أمامها مسارات التخطيط المنفصلة. تخبرك هذه الفجوة البالغة ثماني نقاط بين المقياس النظيف والنسخة «الواقعية غير المنضبطة» (wild) بشيء لا تظهره الأرقام البراقة في ملخص البحث: حتى النموذج المصمم خصيصاً لهذه المشكلة يفقد جزءاً من كفاءته عندما تصبح المدخلات غير منتظمة. هذا ليس تقليلاً من شأن الورقة البحثية، بل هو مؤشر صادق على مدى صعوبة معالجة الصور الملتقطة بالكاميرا، ويجدر تذكره في المرة القادمة التي يزعم فيها أحد المزودين تقديم تقنية OCR «بمستوى الدقة البشرية» استناداً إلى نتائج المستندات الممسوحة ضوئياً وحدها.
أما PureDocBench فهو الاختبار الذي لا يمكنني تفسير نتيجته بالكامل من الملخص فقط. فالاسم يوحي بمستندات نظيفة وغير مشوهة، مما يجعل النتيجة المنخفضة (78.41، وهي أقل حتى من نتيجة المقياس الواقعي "wild") مفاجئة بحق إذا كانت هذه القراءة دقيقة. من المحتمل أن PureDocBench يستهدف نوعاً مختلفاً تماماً من الصعوبة، مثل التخطيطات العلمية الأكثر كثافة، أو محتوى الجداول والمعادلات الأكثر تعقيداً، بدلاً من مسألة التشوه الهندسي. وفي غياب توصيفات الاختبار المعياري الكاملة للورقة بين يدي، سأتعامل مع هذا الرقم كنقطة تحتاج إلى تدقيق إضافي بدلاً من اعتباره حقيقة محسومة، وسأفضل معرفة أنواع المستندات التي تتكون منها تلك المجموعة فعلياً قبل القفز إلى استنتاجات نهائية.
لماذا يهم هذا كل من يبني أو يختار مسار عمل لأنظمة OCR
إذا كنت تبني منتجاً يعالج مستندات واردة من المستخدمين — كفواتير مصورة بالهاتف، أو بطاقات هوية ممسوحة بزاوية، أو إيصالات مرفوعة عبر تطبيق جوال — فإن التمييز بين النهج المنفصل والنهج الشامل في هذه الورقة ليس ترفاً أكاديمياً. إنه يفسر نمط فشل غالباً ما رأيته بنفسك: محلل يعمل بروعة فائقة في بيئة الاختبار مع ملفات PDF النقية، ثم ينهار في اللحظة التي يبدأ فيها المستخدمون الفعليون برفع صور من هواتفهم. وتتضاعف هذه المشكلة عند معالجة النصوص العربية، حيث تزيد طبيعة الخط المتصل، وتغير أشكال الحروف حسب موقعها، والتراكيب الحرفية المعقدة (ligatures)، وعلامات التشكيل من حساسية أنظمة OCR تجاه أي تشوه هندسي في الصفحة الملتقطة.
إليك بعض الخلاصات العملية:
- اختبر أنظمتك بصور الكاميرا، وليس بالمسح الضوئي فقط. إذا كانت مجموعة التقييم لديك تقتصر على المسوحات الضوئية المسطحة أو ملفات PDF النظيفة المصدرة رقمياً، فأنت تقيس الحالة السهلة فقط. إن الفجوة بين OmniDocBench وWild-OmniDocBench في هذه الورقة (96.87 مقابل 88.53) تمثل مؤشراً تقريبياً جيداً لحجم التراجع في الأداء الذي ينبغي أن تتوقعه عند التعامل مع مدخلات العالم الحقيقي.
- احذر تحديداً من الأخطاء التراكمية المتتالية في التخطيط. إذا كنت تعتمد مسار عمل منفصلاً (كشف التخطيط أولاً، ثم التعرف على النص)، فإن الجدول المشوه أو الفقرة المفقودة غالباً ما تكون خطأ في التخطيط يتخفى في زي خطأ في التعرف. افحص مربعات التحديد ودقق فيها قبل أن تبدأ بتصحيح النصوص.
- المستندات الكثيفة بالمعادلات والجداول تتطلب فحصاً يتجاوز النظرة السريعة. يمكن للنموذج أن ينتج جدولاً يبدو صحيحاً للوهلة الأولى ولكنه يتضمن تعييناً غير دقيق بين الصفوف والأعمدة، وهو تحديداً الخلل الذي يهدف أسلوب فصل المحتوى عن البنية إلى معالجته. فإذا كان استخدامك يشمل جداول مالية أو صيغاً علمية، تحقق من البنية الهيكلية ولا تكتفِ بوضوح القراءة فقط.
- نتائج الاختبارات المعيارية في أي ورقة بحثية هي نقطة انطلاق وليست قرار شراء. لا تقدم الملاحظات هنا تفاصيل حول تركيبة بيانات التدريب، أو تكلفة الاستدلال (inference cost)، أو حجم النموذج، وكلها عوامل حاسمة إذا كنت تختار بين هذا النوع من النماذج ومسار عمل أخف وزناً لنظام إنتاجي محكوم بقيود زمن الاستجابة (latency).
ما لا يزال غير واضح
لا يذكر ملخص البحث حجم النموذج، أو سرعة الاستدلال، أو ما إذا كان سيتم إطلاق الأوزان أو الكود المصدري، وهي أمور بالغة الأهمية إذا كنت تقرر ما إذا كنت ستبني حلك على هذا الأساس أم على نظام OCR أصغر حجماً وأقل تكلفة ومتوفر بالفعل. فنموذج VLM متطور يستغرق عدة ثوانٍ لكل صفحة ويتطلب معالج رسومات (GPU) فائق القوة يختلف تماماً في حساباته العملية عن نظام يمكنك تشغيله على نطاق واسع باستخدام عتاد قياسي متاح.
وهناك أيضاً التحفظ المعتاد المصاحب لأي ورقة بحثية تقودها أرقام الاختبارات المعيارية: فالادعاءات بالوصول إلى أحدث ما توصلت إليه التقنية (state-of-the-art) تُقاس بمقارنتها باختبارات اختارها المؤلفون بأنفسهم، وليس من الواضح دائماً كيف صُممت تلك الاختبارات أو ما إذا كانت تغطي أنواع المستندات المحددة التي تهمك. وعلى وجه الخصوص، تستحق نتيجة PureDocBench تدقيقاً أعمق قبل أن يتعامل أي شخص مع هذه الأرقام ككلمة فصل في مدى قدرة النموذج على التعميم.
مع ذلك، تظل الفكرة الجوهرية هنا وجيهة وتستحق الاهتمام بغض النظر عن مدى صمود تلك الأرقام المحددة أمام التدقيق: فقد ظل تحليل المستندات لسنوات يُحسَّن في صمت للتعامل مع مدخلات نظيفة ومسطحة ومضاءة جيداً، في حين أن جانباً هائلاً من التقاط المستندات في الواقع العملي يتم عبر كاميرات الهواتف في ظروف إضاءة غير مثالية. والنموذج الذي يتعامل مع التشوه الهندسي كعنصر يجب تعلمه وفهمه بدلاً من اعتباره تشويشاً يُزال في مرحلة المعالجة المسبقة يتجه نحو المشكلة الصحيحة. أما ما إذا كان هو النموذج الذي ستعتمده فعلياً في مسار عملك فهذا سؤال آخر، يستحق أن تختبره بنفسك باستخدام مستنداتك الواقعية المصورة وغير المنضبطة، بدلاً من الاكتفاء بالثقة العمياء في جداول الاختبارات المعيارية.