为什么拍摄文档仍然会破坏大多数OCR模型
参考论文: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
现在拿出你的手机,拍一张放在桌上的收据。不是扫描,是拍照,就像你为报销或税务应用所做的那样。看看结果:纸张边缘微微卷曲,一个角比另一个角更靠近镜头,折叠附近的文字弯曲得足以让直线变形。在你的眼中,这一切看起来都没问题。但对大多数 OCR 系统来说,这简直是个雷区。
“实验室中扫描的文档”与“现实生活中拍摄的文档”之间的差距,正是新论文《NaviDC-OCR》直面的问题。该名称代表“在数字和相机捕获文档间导航文档解析”,研究团队(根据所属机构,来自中国多家 AI 实验室的研究人员)构建了一个模型,旨在同时良好处理这两种情况,而不是在文档不再平整且光照完美时悄然退化。
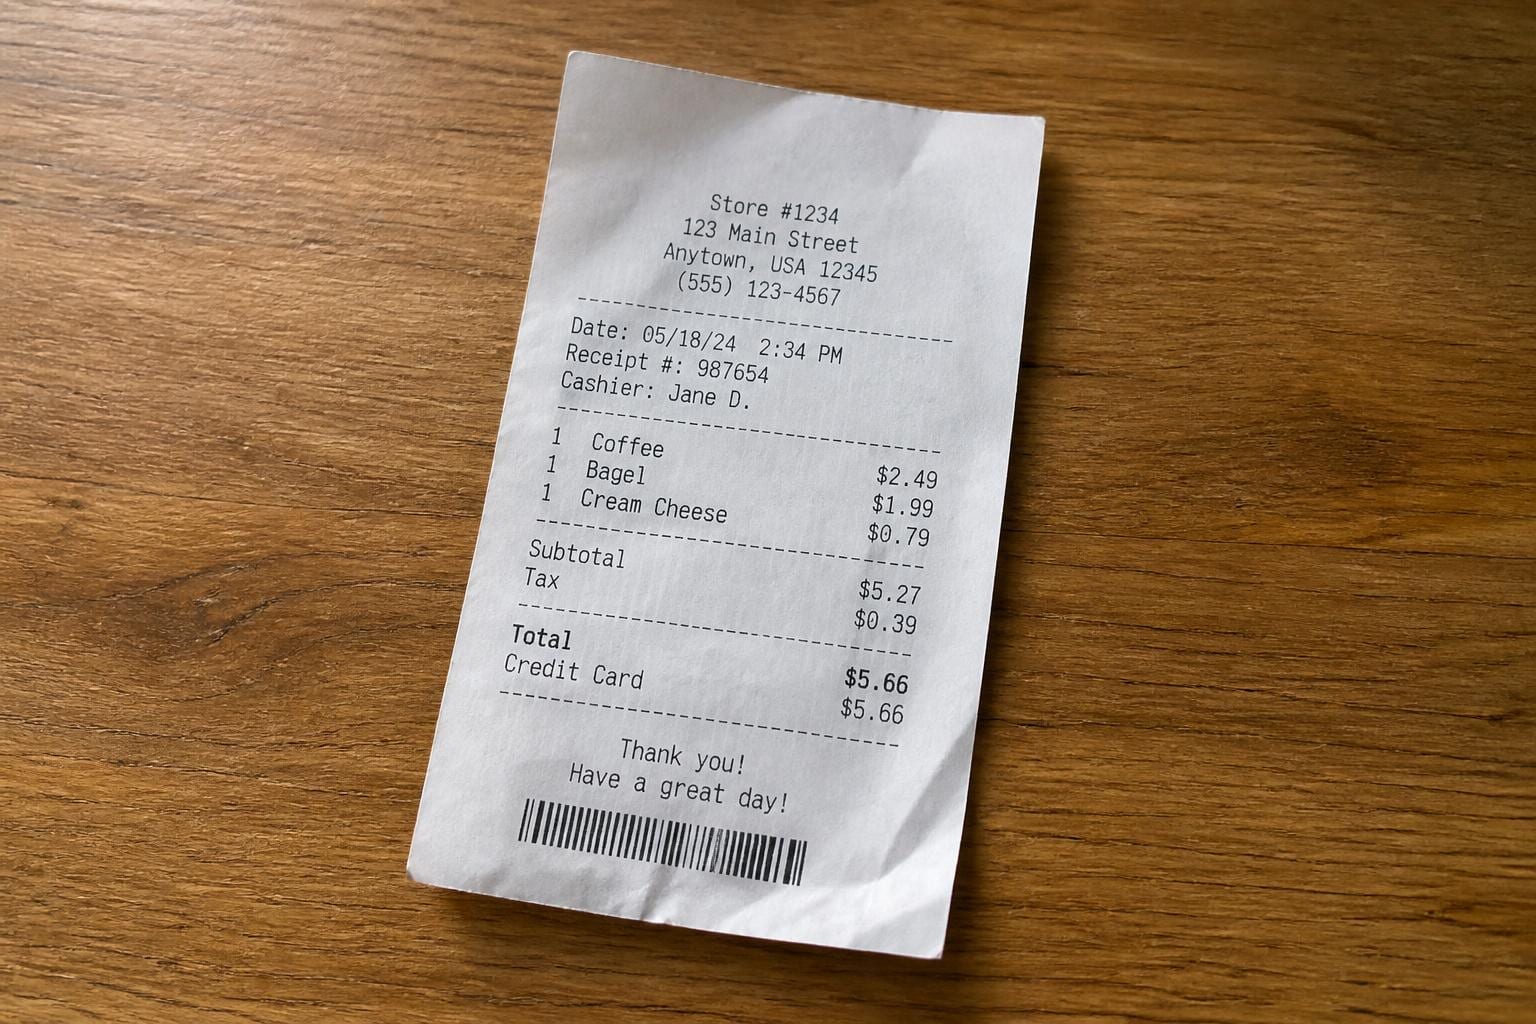
构建文档解析器的两种方法,以及它们各自的陷阱
现代文档解析——即将页面图像转换为计算机可实际使用的结构化文本、表格和公式的任务——主要遵循两种模式之一。
第一种是论文中所谓的“解耦方法”。首先进行版面分析:找到文本块、表格和图表,在它们周围画出边界框,然后将每个边界框输入识别模型以提取实际内容。这是一种清晰的分工方式,在处理平面扫描图像时效果良好。然而,问题出现在相机拍摄的照片上。如果页面发生扭曲、倾斜或部分阴影,版面检测器会画出错误的边界框,而后续的所有步骤都会继承这一错误。略微弯曲的表格行可能被裁剪成两个框;围绕书脊弯曲的段落可能在错误的位置被分割。如果在第一步中几何结构出错,后续步骤无法完全恢复。
第二种模式是端到端方法:跳过显式的版面检测,让单个视觉-语言模型(VLM,一种接收图像并生成文本的神经网络,与驱动现代聊天机器人图像理解能力的模型属于同一类)读取整个页面并直接生成结构化输出。这避免了级联错误问题,但引入了另一个问题。在高分辨率下,这些模型往往会出现冗余输出:重复行、生成页面上不存在的内容(幻觉),或在密集版面中迷失方向。将包含内联公式和表格的双栏论文整页输入模型,它并不总能准确判断一个部分的结束和下一个部分的开始。
这两种失败模式源于同一个根本原因:页面上的文本不仅仅是字符,而是位于几何结构中的字符,一旦现实因素介入,这种结构就更难被准确解读。
教会模型“扭曲”到底长什么样
NaviDC-OCR 的第一个改进措施是论文中提到的“形变感知学习”(deformation-aware learning)。其核心思想是显式地训练模型去感知几何失真、卷曲、倾斜和透视畸变——这些是相机拍摄照片时特有的现象,而平板扫描仪则不会产生。这种方法不再寄希望于模型通过接触大量照片而偶然学会这些特征,而是直接将其作为学习目标。
想象一下,一个只读过平铺在玻璃下的打印页的人,与一个在公交车上多年阅读以各种角度手持书籍的人之间的区别。后者已经建立了一种直觉:“这条线实际上是直的,只是因为页面的弯曲而看起来是弯的。” NaviDC-OCR 正是试图直接将这种先验知识融入模型,而不是将其留给偶然性。
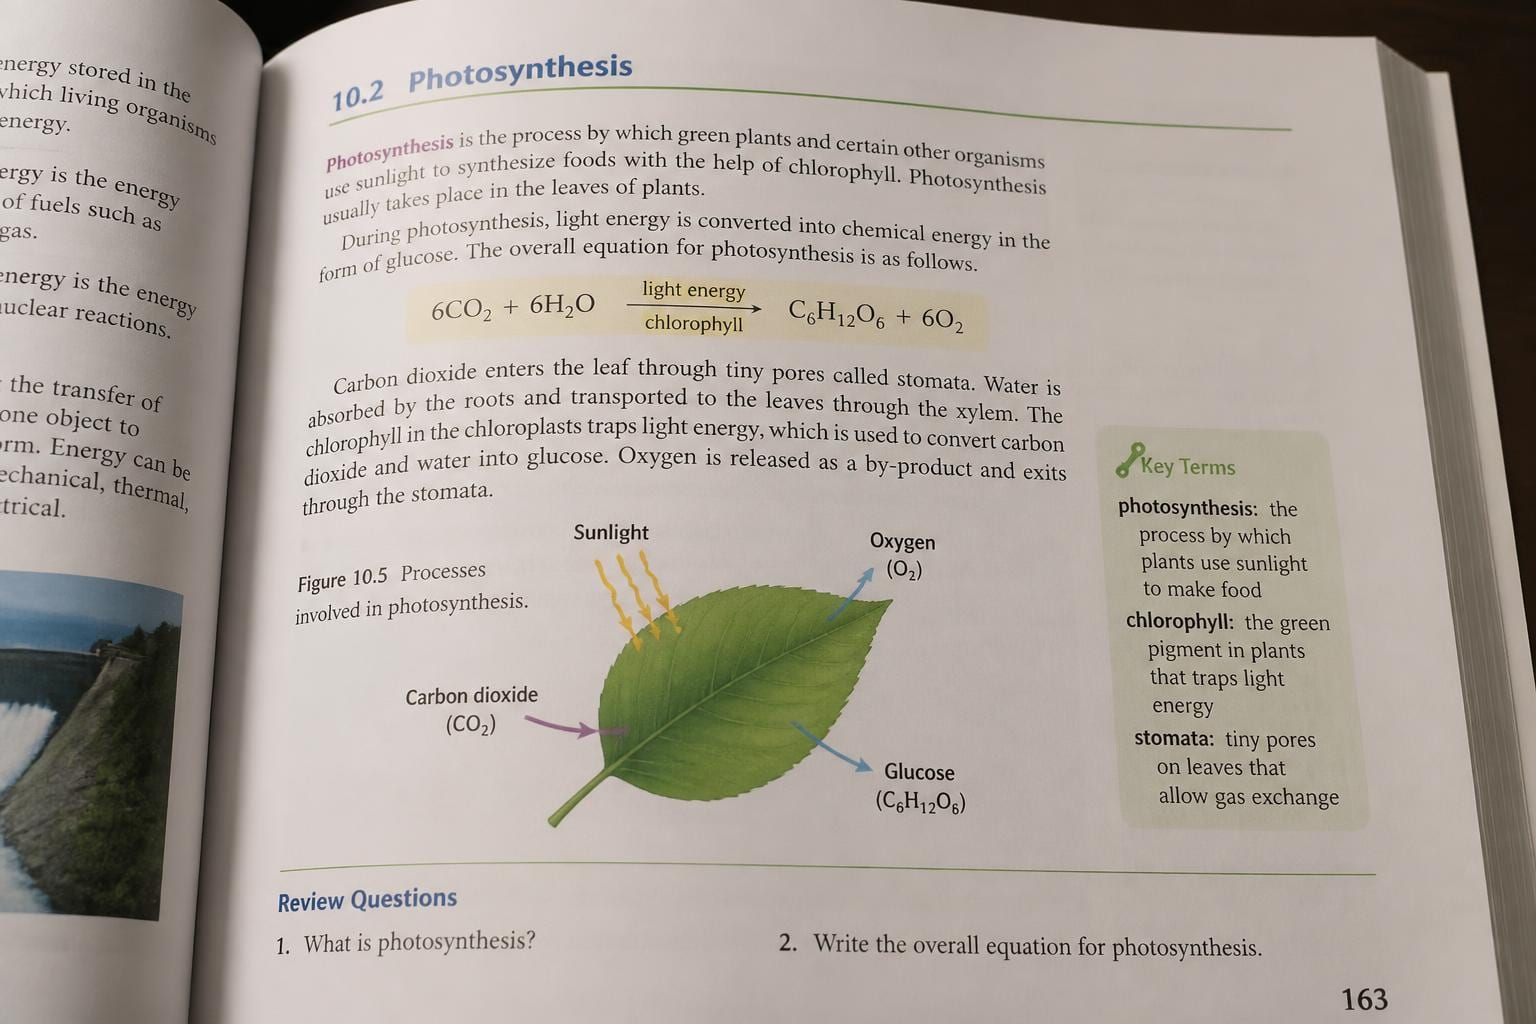
第二个组成部分是针对复杂版式的自适应采样机制。高分辨率文档图像在全细节下处理成本高昂,因此大多数视觉语言模型(VLM)在将图像输入模型之前会对其进行下采样或分块处理。均匀网格以相同的方式处理密集表格和宽边距,这会在空白区域浪费分辨率,而真正需要高分辨率的区域却得不到足够的资源。自适应采样则相反,它将更多的注意力分配给视觉上复杂的区域,如表格、公式和拥挤的多栏文本,而对简单区域分配较少的注意力。这相当于浏览报告时的视觉策略:你不会以阅读第 12 页隐藏的电子表格的速度去阅读空白区域。
公式和表格不仅仅是形状奇特的文本
第三项贡献解决了一个让许多端到端 OCR 系统头疼的问题:公式和表格并非普通文本。公式具有语法结构,因为符号的排列方式承载着意义;分数线在结构上的含义与上标截然不同。表格则由行、列以及合并单元格构成,这些元素定义了数值之间的关系,而不仅仅是一串字符序列。
主要在连续文本上训练的模型往往将这些内容视为难以阅读的文本,一旦产生混淆,就会生成看似合理实则荒谬的结果,例如错误的指数、错位的小数点,或是悄无声息地与相邻单元格合并的表格单元。NaviDC-OCR 的解决方案是内容与结构解耦学习:训练模型分别推理结构(这是一个 4x6 的表格,这是一个具有特定分子和分母的分数)和内容(实际的字符是什么),而不是将两者混合在一个生成任务中。这有点像将“这座建筑是什么形状”与“门口招牌上写着什么”分开处理,而不是指望一眼就能同时回答这两个问题。
基准测试数据究竟揭示了什么
论文报告了在三个基准测试上的得分:OmniDocBench v1.6 上为 96.87,Wild-OmniDocBench 上为 88.53,PureDocBench 上为 78.41。此外,该论文还声称在 ICDAR 2026 Sci-ImageMiner Challenge(一项针对文档和科学图像解析的国际竞赛赛道)中夺得第一名。
OmniDocBench 是一个成熟的基准测试,涵盖了广泛的文档类型,包括学术论文、教科书、试卷和财务报告,并同时评估版面检测和文本识别能力。在该基准测试中获得 90 多分的高分,意味着模型在处理那些与大多数解析器优化目标相近的训练分布文档时表现非常出色。
引人关注的数字是 Wild-OmniDocBench 上降至 88.53 的得分。鉴于其名称以及论文明确关注相机拍摄的文档,这几乎可以肯定是更困难的、真实世界照片变体:那些卷曲的收据、倾斜角度的书页以及不一致的光线,这些正是导致解耦版面流水线失效的因素。干净基准测试与“野外”基准测试之间八分的差距揭示了一些摘要中的头条数字所没有告诉你的信息:即使是专为解决这个问题而构建的模型,当输入变得杂乱时,性能依然会下降。这并不是对论文的批评,而是关于相机拍摄场景实际上有多困难的一个诚实信号,下次当供应商仅基于扫描文档基准测试就声称“人类级 OCR”时,这一点值得牢记。
PureDocBench 是我无法仅从摘要中完全解释清楚的基准测试。其名称暗示了干净、无失真的文档,如果这种理解是正确的,那么较低的得分(78.41,甚至低于“野外”基准测试)确实令人惊讶。PureDocBench 可能针对的是完全不同的难度类型,例如更密集的科学版面、更复杂的公式和表格内容,而非失真问题。由于手头没有论文中关于基准测试的完整描述,我会将该数字视为一个需要深入挖掘的标志,而不是既定事实,并且在从中得出结论之前,我希望了解该数据集中实际包含哪些文档类型。
为何这对构建或选择 OCR 流程至关重要
如果你的产品需要处理用户提交的文档——无论是手机拍摄的照片、倾斜扫描的身份证件,还是通过移动应用上传的收据——那么本文所讨论的“解耦式”与“端到端”架构之分就绝非纸上谈兵。它解释了一种你可能已经遇到过的故障模式:解析器在干净的 PDF 测试集中表现完美,但一旦真实用户开始上传手机照片,系统便立刻崩溃。
几点实用的建议:
- 使用相机照片进行测试,而不仅仅是扫描件。 如果你的评估集全是平板扫描仪生成的图像或干净的 PDF 导出文件,那么你测量的只是理想情况。本文中介于 OmniDocBench 和 Wild-OmniDocBench 之间的性能差距(96.87 对比 88.53)是一个合理的参考指标,预示了你在处理真实世界输入时可能面临的性能下降幅度。
- 特别注意级联布局错误。 如果你使用的是解耦式流程(先检测布局,再进行识别),混乱的表格或缺失的段落往往是布局错误披上了识别错误的外衣。在调试文本之前,先调试边界框(boxes)。
- 富含公式和表格的文档需要超越肉眼观察的严格审查。 模型生成的表格乍看之下可能正确,但行列映射可能存在细微错误,这正是内容-结构解耦旨在减少的失败类型。如果你的用例涉及财务表格或科学公式,请抽查结构准确性,而不仅仅是可读性。
- 任何单篇论文中的基准数据只是起点,而非购买决策依据。 本文并未说明训练数据构成、推理成本或模型大小,而如果你要在该模型与满足生产系统延迟约束的轻量级流程之间做出选择,这些因素至关重要。鉴于中文汉字属于表意文字,具有字符数量庞大、版面布局密集的特点,若该研究主要基于英文/拉丁字母文本,其在处理中文复杂排版时的泛化能力需额外验证。
尚不明确之处
摘要中并未提及模型规模、推理速度,也未说明是否会开源权重或代码。如果你正在权衡是基于该模型进行开发,还是采用更小、更便宜且已可用的 OCR 系统,这些细节至关重要。一个需要强大 GPU 支持且每页推理耗时数秒的最先进视觉语言模型(VLM),与可以在通用硬件上大规模运行的方案有着天壤之别。
此外,任何基于基准测试的论文都存在老生常谈的局限性:所谓“最先进”的声明都是基于作者所选定的基准进行衡量的,而这些基准的构建方式及其是否涵盖你所关心的特定文档类型,往往并不透明。特别是 PureDocBench 的结果,在将其视为该模型泛化能力的最终定论之前,值得更仔细地审视。
尽管如此,无论具体数据在严格审查下表现如何,其核心思路是合理且值得关注的:多年来,文档解析技术一直在针对清晰、平整、光照良好的输入进行优化,而现实中大量的文档采集都是通过手机摄像头在不完美的光照条件下完成的。一种将几何畸变视为需要学习的内容而非需要预处理消除的噪声的模型,确实瞄准了正确的问题。至于它是否最终会部署到你的流水线中,则是另一个问题,值得用你自己那些杂乱、真实且由手机拍摄的文档进行实测,而不是仅仅相信基准测试表格中的数据。