किसी दस्तावेज़ की फ़ोटो खींचना आज भी अधिकांश OCR मॉडल्स को क्यों फ़ेल कर देता है
आधारित शोध-पत्र: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
अभी अपना फ़ोन निकालिए और डेस्क पर रखी किसी रसीद (receipt) की फ़ोटो खींचिए। उसे स्कैन नहीं करना है, बल्कि वैसे ही फ़ोटो खींचनी है जैसे आप किसी एक्सपेंस रिपोर्ट या टैक्स ऐप के लिए खींचते हैं। अब इसके नतीजे को देखिए: कागज़ के किनारे थोड़े मुड़े हुए हैं, एक कोना लेंस के थोड़ा ज़्यादा क़रीब है, और फ़ोल्ड के पास का टेक्स्ट इतना मुड़ गया है कि वह सीधी रेखा में नहीं दिखता। आपकी आँखों को इसमें कुछ भी टूटा या ख़राब नहीं लगेगा। लेकिन ज़्यादातर OCR सिस्टम्स के लिए यह किसी बारूदी सुरंग (minefield) जैसा है।
‘लैब में स्कैन किए गए दस्तावेज़ों’ और ‘असल ज़िंदगी में फ़ोटो खींचे गए दस्तावेज़ों’ के बीच का यही अंतर वह समस्या है, जिससे NaviDC-OCR नाम का एक नया पेपर सीधे तौर पर निपटता है। इसका पूरा नाम Navigating Document Parsing Across Digital and Camera-Captured Documents है, और इस टीम ने (एफ़िलिएशन के आधार पर, चीनी AI लैब्स के शोधकर्ताओं का मिला-जुला समूह) एक ऐसा मॉडल तैयार किया है जो दोनों ही तरह के मामलों को बख़ूबी संभालने के लिए डिज़ाइन किया गया है—बजाय इसके कि जैसे ही कोई दस्तावेज़ सपाट न रहे या रोशनी कमज़ोर पड़े, मॉडल का परफ़ॉर्मेंस चुपचाप गिरने लगे।
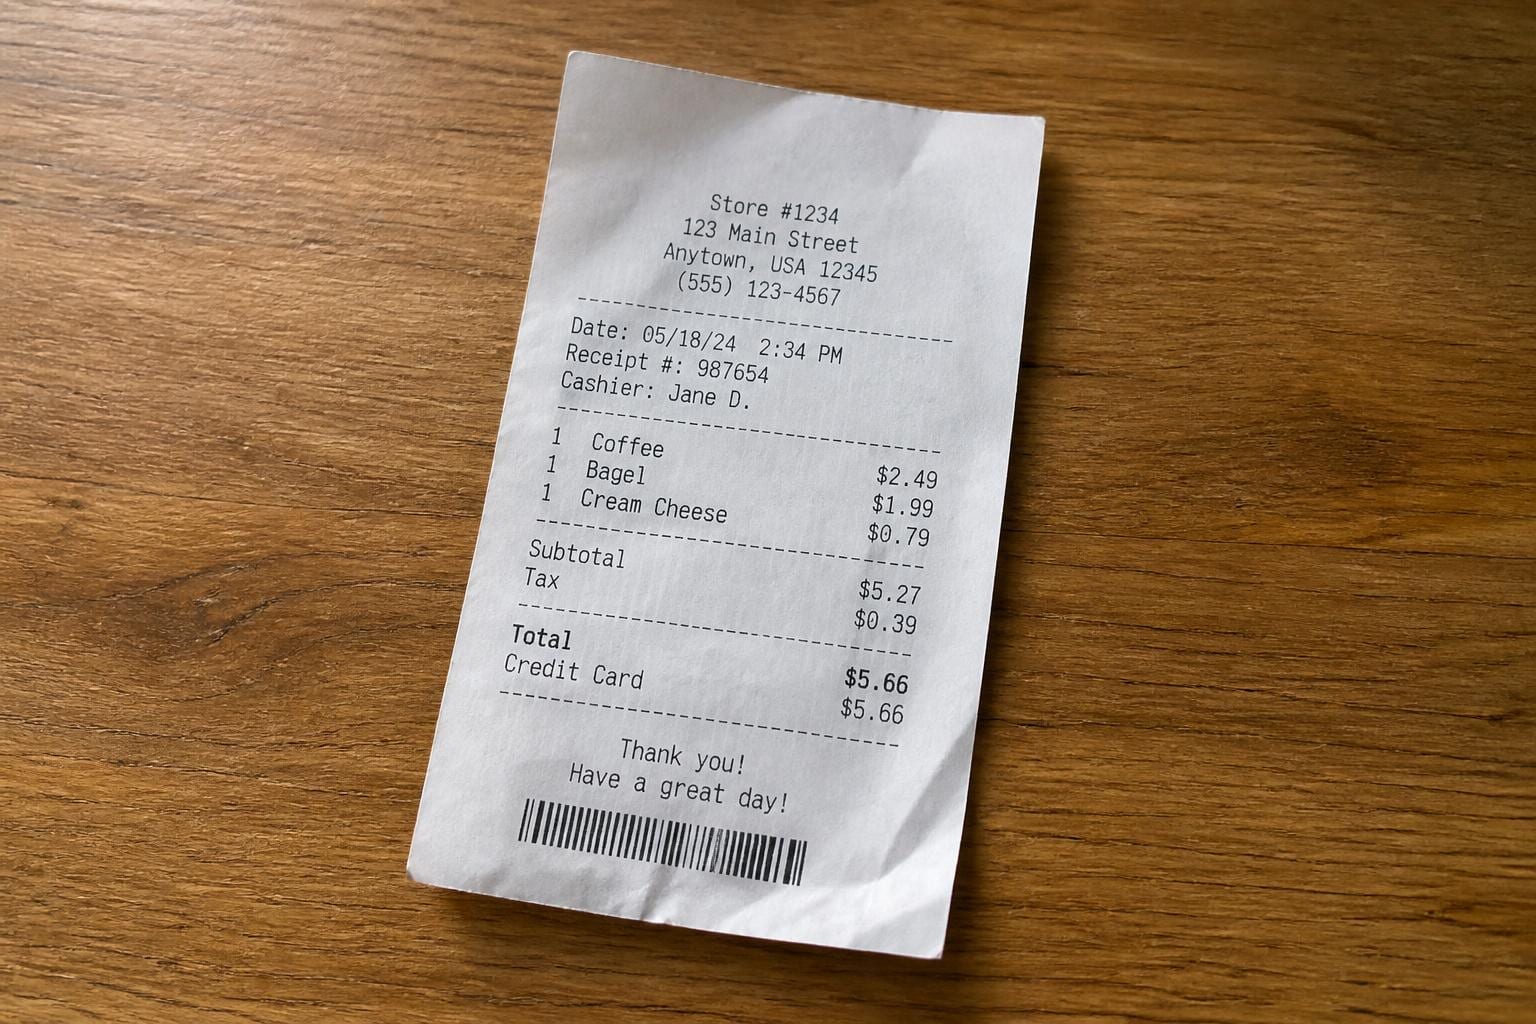
डॉक्यूमेंट पार्सर बनाने के दो तरीके, और दोनों में ही एक पेंच क्यों है
मॉडर्न डॉक्यूमेंट पार्सिंग—यानी किसी पेज इमेज को ऐसे स्ट्रक्चर्ड टेक्स्ट, टेबल्स और फ़ॉर्मूलों में बदलना जिसे कंप्यूटर असल में इस्तेमाल कर सके—मुख्य रूप से दो में से किसी एक तरीक़े (playbook) पर चलती है।
पहला तरीका वह है जिसे पेपर decoupled approach कहता है। इसमें आप पहले लेआउट एनालिसिस (layout analysis) चलाते हैं: टेक्स्ट ब्लॉक्स, टेबल्स और फ़िगर्स को ढूँढते हैं, उनके चारों ओर बॉक्सेज़ बनाते हैं, और फिर असल कंटेंट निकालने के लिए हर बॉक्स को एक रिकग्निशन मॉडल में फ़ीड करते हैं। यह काम का एक साफ़-सुथरा बँटवारा है, और जब इनपुट कोई फ़्लैट स्कैन हो तो यह बहुत बढ़िया काम करता है। लेकिन पेंच तब आता है जब बात कैमरे से ली गई फ़ोटो की हो। अगर कोई पेज मुड़ा हुआ (warped), झुका हुआ (tilted) या आंशिक रूप से परछाई में हो, तो लेआउट डिटेक्टर ग़लत बॉक्स बना देता है, और बाद का हर स्टेप उस ग़लती को आगे बढ़ा देता है। थोड़ी सी मुड़ी हुई टेबल की रो कटकर दो अलग बॉक्सेज़ में बँट जाती है; किताब की स्पाइन के पास मुड़ने वाला पैराग्राफ़ ग़लत जगह से स्प्लिट हो जाता है। अगर पहले ही कदम पर ज्योमेट्री ग़लत हो गई, तो उसके बाद कुछ भी पूरी तरह ठीक नहीं हो पाता।
दूसरा तरीक़ा end-to-end है: इसमें अलग से लेआउट डिटेक्शन को छोड़ दिया जाता है और एक अकेला विज़न-लैंग्वेज मॉडल (VLM—एक ऐसा न्यूरल नेटवर्क जो इमेज लेकर टेक्स्ट जनरेट करता है, ठीक उसी फ़ैमिली का मॉडल जो मॉडर्न चैटबॉट्स की इमेज समझने की क्षमता के पीछे होता है) पूरे पेज को पढ़ता है और सीधे स्ट्रक्चर्ड आउटपुट तैयार करता है। यह कास्केडिंग एरर (cascading error) की समस्या से तो बचा लेता है, लेकिन उसके बदले एक नई मुसीबत खड़ी कर देता है। हाई रेज़ोल्यूशन पर, ये मॉडल्स अक्सर बहकने (ramble) लगते हैं: पंक्तियों को दोहराना, ऐसा कंटेंट गढ़ना जो पेज पर है ही नहीं (hallucination), या किसी घने लेआउट में यह भूल जाना कि वे अभी कहाँ हैं। किसी मॉडल को दो कॉलम वाले रिसर्च पेपर का पूरा पन्ना दीजिए जिसमें इनलाइन फ़ॉर्मूला और एक टेबल भी हो, तो वह हमेशा यह नहीं समझ पाता कि एक सेक्शन कहाँ ख़त्म हुआ और अगला कहाँ से शुरू।
विफलता के ये दोनों रूप एक ही मूल कारण से पैदा होते हैं: किसी पेज पर मौजूद टेक्स्ट सिर्फ़ कैरेक्टर्स नहीं होते, बल्कि वे एक ज्योमेट्रिक स्ट्रक्चर के भीतर बैठे कैरेक्टर्स होते हैं—और जैसे ही असल दुनिया की परिस्थितियाँ सामने आती हैं, उस स्ट्रक्चर को पढ़ना उतना ही मुश्किल हो जाता है।
मॉडल को यह सिखाना कि असल में "मुड़ा हुआ" (warped) कैसा दिखता है
NaviDC-OCR का पहला समाधान वह है जिसे पेपर deformation-aware learning कहता है। इसका विचार मॉडल को साफ़ तौर पर ज्योमेट्रिक डिस्टॉर्शन—जैसे मुड़ाव (curl), झुकाव (tilt), पर्सपेक्टिव स्क्यू (perspective skew)—पहचानने के लिए ट्रेन करना है; यानी वे चीज़ें जो कैमरे की फ़ोटो में आ जाती हैं पर फ़्लैटबेड स्कैनर में कभी नहीं आतीं। बजाय इसके कि हम यह उम्मीद लगाए बैठे रहें कि हज़ारों फ़ोटो देखने के बाद मॉडल इसे अपने आप किसी साइड इफ़ेक्ट की तरह सीख ही जाएगा।
ज़रा उस इंसान के फ़र्क के बारे में सोचिए जिसने सिर्फ़ शीशे के नीचे सपाट रखे प्रिंटेड पन्ने पढ़े हैं, और उस इंसान के बारे में जिसने सालों तक बस में अजीब-अजीब एंगल्स पर किताबें पकड़े हुए पढ़ी हैं। दूसरे इंसान के भीतर यह अंतर्ज्ञान (intuition) विकसित हो जाता है कि "यह लाइन वास्तव में सीधी है, पन्ने के मुड़ने के कारण यह सिर्फ़ घुमावदार दिख रही है।" NaviDC-OCR इसी तरह के प्रायर (prior) को क़िस्मत के भरोसे छोड़ने के बजाय सीधे मॉडल में उतारने (bake in करने) की कोशिश कर रहा है।
दूसरा हिस्सा जटिल लेआउट्स के लिए एक adaptive sampling मैकेनिज़्म है। हाई-रेज़ोल्यूशन डॉक्यूमेंट इमेजेस को पूरी बारीकी के साथ प्रोसेस करना काफ़ी महँगा होता है, इसलिए ज़्यादातर VLMs मॉडल में फ़ीड करने से पहले इमेज को डाउनसैंपल या टाइल (tile) कर देते हैं। एक यूनिफ़ॉर्म ग्रिड किसी घनी टेबल और एक चौड़े खाली मार्जिन को एक ही नज़र से देखता है, जिससे खाली जगह पर रेज़ोल्यूशन बर्बाद होता है और उन हिस्सों को ज़रूरी डिटेल नहीं मिल पाती जिन्हें इसकी असल ज़रूरत है। इसके विपरीत, एडेप्टिव सैंपलिंग विज़ुअली जटिल क्षेत्रों—जैसे टेबल्स, फ़ॉर्मूले, सघन मल्टी-कॉलम टेक्स्ट—को ज़्यादा अटेंशन देती है और आसान हिस्सों को कम। यह किसी रिपोर्ट को सरसरी तौर पर पढ़ने (skimming) जैसा ही विज़ुअल अनुभव है: आप खाली स्पेस को उसी रफ़्तार से नहीं पढ़ते जिस रफ़्तार से पेज 12 पर दबी हुई स्प्रेडशीट को पढ़ते हैं।
फ़ॉर्मूले और टेबल्स सिर्फ़ असामान्य आकार वाले टेक्स्ट नहीं हैं
तीसरा योगदान उस समस्या को हल करता है जो कई end-to-end OCR सिस्टम्स को उलझा देती है: फ़ॉर्मूले और टेबल्स कोई सामान्य गद्य (prose) नहीं हैं। फ़ॉर्मूले का अपना एक व्याकरण (grammar) होता है, इस अर्थ में कि सिम्बल्स की बनावट ही अर्थ को एनकोड करती है; एक फ़्रैक्शन बार (fraction bar) स्ट्रक्चर के लिहाज़ से सुपरस्क्रिप्ट (superscript) से बिल्कुल अलग मायने रखता है। एक टेबल में रो, कॉलम और मर्ज्ड सेल्स होते हैं जो वैल्यूज़ के बीच के रिश्तों को परिभाषित करते हैं, न कि सिर्फ़ कैरेक्टर्स का कोई क्रम।
मुख्य रूप से सामान्य बहते हुए टेक्स्ट पर ट्रेन किए गए मॉडल्स इन्हें सिर्फ़ 'मुश्किल से पढ़े जाने वाले टेक्स्ट' के रूप में देखने लगते हैं और जब वे कन्फ़्यूज़ होते हैं, तो ऐसा बकवास आउटपुट जनरेट कर देते हैं जो पहली नज़र में सही लगता है—जैसे कोई ग़लत एक्सपोनेंट, अपनी जगह से खिसका हुआ दशमलव, या टेबल का कोई ऐसा सेल जो चुपचाप अपने बगल वाले सेल में मिल जाता है। NaviDC-OCR का जवाब है content-structure decoupled learning: दोनों चीज़ों को एक ही जनरेशन टास्क में मिलाने के बजाय, मॉडल को स्ट्रक्चर (यह एक 4x6 की टेबल है, यह इस न्यूमरेटर और डिनॉमिनेटर वाला फ़्रैक्शन है) और कंटेंट (असल कैरेक्टर्स क्या हैं) के बारे में अलग-अलग तर्क (reason) करने के लिए ट्रेन करना। यह कुछ वैसा ही है जैसे "इस इमारत का आकार कैसा है" को "सामने लगे बोर्ड पर क्या लिखा है" से अलग करके देखना, बजाय इसके कि एक ही नज़र में दोनों का पता लगाने की उम्मीद की जाए।
बेंचमार्क के आंकड़े असल में क्या दिखाते हैं
यह पेपर तीन बेंचमार्क्स पर स्कोर रिपोर्ट करता है: OmniDocBench v1.6 पर 96.87, Wild-OmniDocBench पर 88.53, और PureDocBench पर 78.41। यह ICDAR 2026 Sci-ImageMiner Challenge—जो डॉक्यूमेंट और साइंटिफ़िक-इमेज पार्सिंग का एक अंतरराष्ट्रीय कॉम्पिटिशन ट्रैक है—में पहला स्थान हासिल करने का भी दावा करता है।
OmniDocBench एक जाना-माना बेंचमार्क है जो विभिन्न प्रकार के दस्तावेज़ों—एकेडेमिक पेपर्स, टेक्स्टबुक्स, एग्ज़ाम शीट्स, फ़ाइनेंशियल रिपोर्ट्स—को कवर करता है, और यह लेआउट डिटेक्शन तथा टेक्स्ट रिकग्निशन दोनों का एक साथ मूल्यांकन करता है। वहाँ 90 से ऊपर का हाई स्कोर यह दिखाता है कि मॉडल उन दस्तावेज़ों पर बहुत अच्छा प्रदर्शन कर रहा है जो उस ट्रेनिंग डिस्ट्रीब्यूशन के काफ़ी क़रीब हैं जिसके लिए ज़्यादातर पार्सर्स ऑप्टिमाइज़ किए जाते हैं।
दिलचस्प आंकड़ा Wild-OmniDocBench पर गिरकर 88.53 हो जाना है। इसके नाम और कैमरा-कैप्चर्ड दस्तावेज़ों पर पेपर के फ़ोकस को देखते हुए, यह निश्चित रूप से अधिक कठिन, रियल-वर्ल्ड फ़ोटो वाला वैरिएंट है: मुड़ी-तुड़ी रसीदें, टेढ़े एंगल्स वाले किताबों के पन्ने, और असंगत रोशनी जिन पर decoupled लेआउट पाइपलाइन्स अटक जाती हैं। साफ़-सुथरे बेंचमार्क और इस "wild" बेंचमार्क के बीच का यह आठ अंकों का अंतर वह बात बताता है जो एब्स्ट्रैक्ट के हेडलाइन आंकड़े नहीं बताते: विशेष रूप से इसी समस्या के लिए बना मॉडल भी इनपुट के उलझते ही अपनी पकड़ खोने लगता है। यह पेपर की कोई आलोचना नहीं है, बल्कि एक सच्चा संकेत है कि कैमरे से ली गई फ़ोटो का मामला वास्तव में कितना कठिन है—और अगली बार जब कोई वेंडर सिर्फ़ स्कैन किए गए दस्तावेज़ों के बेंचमार्क के आधार पर "human-level OCR" का दावा करे, तो इसे याद रखना चाहिए।
PureDocBench एक ऐसा बेंचमार्क है जिसे मैं एब्स्ट्रैक्ट के आधार पर पूरी तरह नहीं समझा सकता। इसके नाम से साफ़, बिना किसी डिस्टॉर्शन वाले दस्तावेज़ों का आभास होता है, जिससे यह कम स्कोर (78.41, जो कि "wild" बेंचमार्क से भी कम है) सचमुच हैरान करने वाला है, बशर्ते यह व्याख्या सही हो। संभव है कि PureDocBench डिस्टॉर्शन के बजाय किसी बिल्कुल अलग तरह की कठिनाई को टारगेट करता हो—जैसे बहुत घने साइंटिफ़िक लेआउट्स, या अधिक जटिल फ़ॉर्मूले और टेबल कंटेंट। सामने पूरे पेपर के बेंचमार्क विवरण के बिना, मैं इस आंकड़े को कोई तय तथ्य मानने के बजाय एक ऐसा संकेत मानूँगा जिसकी गहराई में जाने की ज़रूरत है, और कोई निष्कर्ष निकालने से पहले यह देखना चाहूँगा कि उस सेट में असल में किस तरह के दस्तावेज़ शामिल हैं।
OCR पाइपलाइन बनाने या चुनने वाले किसी भी व्यक्ति के लिए यह क्यों मायने रखता है
अगर आप ऐसा प्रोडक्ट बना रहे हैं जो यूज़र्स से दस्तावेज़ लेता है—फ़ोन से खींचे गए इनवॉइस, किसी एंगल पर स्कैन किए गए आईडी कार्ड्स, या मोबाइल ऐप से सबमिट की गई रसीदें—तो इस पेपर में decoupled बनाम end-to-end का अंतर सिर्फ़ किताबी नहीं है। यह उस फ़ेलियर मोड को समझाता है जिसे आपने शायद पहले ही देखा होगा: एक पार्सर जो साफ़-सुथरे PDFs के आपके टेस्ट सूट में तो शानदार काम करता है, लेकिन जैसे ही असली यूज़र्स अपने फ़ोन से फ़ोटो अपलोड करना शुरू करते हैं, वह बिखर जाता है। और जहाँ बात भारतीय संदर्भ की हो, वहाँ यह भी याद रखना ज़रूरी है कि अंग्रेज़ी में दमदार OCR का मतलब यह कतई नहीं होता कि वह शिरोरेखा, नुक्ते, मात्राओं और जटिल संयुक्त अक्षरों वाली देवनागरी लिपि पर भी उतना ही सटीक साबित होगा।
कुछ व्यावहारिक निष्कर्ष (takeaways):
- सिर्फ़ स्कैन ही नहीं, बल्कि कैमरे की फ़ोटो के साथ भी टेस्ट करें। अगर आपका इवैल्यूएशन सेट सिर्फ़ फ़्लैटबेड स्कैन या साफ़-सुथरे PDF एक्सपोर्ट्स का है, तो आप केवल आसान केस की ही जाँच कर रहे हैं। इस पेपर में OmniDocBench और Wild-OmniDocBench के बीच का अंतर (96.87 बनाम 88.53) एक सही पैमाना है कि रियल-वर्ल्ड इनपुट पर परफ़ॉर्मेंस में कितनी गिरावट की उम्मीद की जानी चाहिए।
- खास तौर पर कास्केडिंग लेआउट एरर्स पर नज़र रखें। अगर आप decoupled पाइपलाइन (पहले लेआउट डिटेक्शन, फिर रिकग्निशन) का इस्तेमाल कर रहे हैं, तो किसी टेबल का बिगड़ना या पैराग्राफ़ का गायब होना अक्सर रिकग्निशन की नहीं, बल्कि लेआउट की ही कोई छिपी हुई गड़बड़ी होती है। टेक्स्ट को डिबग करने से पहले बॉक्सेज़ को डिबग करें।
- फ़ॉर्मूलों और टेबल्स से भरे दस्तावेज़ों को केवल सरसरी नज़र से देखने के बजाय गहन जाँच की ज़रूरत होती है। एक मॉडल ऐसी टेबल बना सकता है जो पहली नज़र में सही दिखे लेकिन उसमें रो-कॉलम की मैपिंग में बारीक ग़लतियाँ हों—यह ठीक वही कमी है जिसे content-structure decoupling द्वारा कम करने का लक्ष्य रखा गया है। अगर आपके यूज़ केस में फ़ाइनेंशियल टेबल्स या साइंटिफ़िक फ़ॉर्मूले शामिल हैं, तो सिर्फ़ टेक्स्ट की पठनीयता (legibility) ही नहीं, बल्कि उसके स्ट्रक्चर की भी जाँच करें।
- किसी एक पेपर के बेंचमार्क आंकड़े सिर्फ़ शुरुआत का बिंदु होते हैं, कोई ख़रीद का फ़ैसला नहीं। यहाँ रिलीज़ नोट्स में ट्रेनिंग डेटा कंपोज़िशन, इनफ़रेंस कॉस्ट या मॉडल साइज़ के बारे में कुछ नहीं बताया गया है—जबकि लेटेंसी की सीमाओं वाले किसी प्रोडक्शन सिस्टम के लिए ऐसे मॉडल और हल्के वज़न की पाइपलाइन के बीच चुनाव करते समय ये बातें बहुत मायने रखती हैं।
अभी भी क्या स्पष्ट नहीं है
एब्स्ट्रैक्ट में मॉडल के साइज़, इनफ़रेंस स्पीड, या इसके वेट्स (weights) व कोड जारी किए जाएँगे या नहीं, इसका कोई ज़िक्र नहीं है—जबकि यदि आप इस पर सिस्टम खड़ा करने या किसी छोटे, सस्ते और पहले से उपलब्ध OCR सिस्टम के बीच फ़ैसला कर रहे हों, तो ये बातें बहुत मायने रखती हैं। एक ऐसा स्टेट-ऑफ़-द-आर्ट VLM जो प्रति पेज कई सेकंड का समय लेता हो और जिसके लिए एक तगड़े GPU की ज़रूरत हो, उस सिस्टम से बिल्कुल अलग स्थिति पेश करता है जिसे आप सामान्य हार्डवेयर (commodity hardware) पर बड़े पैमाने पर चला सकते हैं।
किसी भी बेंचमार्क-आधारित पेपर के साथ हमेशा की तरह यह चेतावनी भी जुड़ी होती है: स्टेट-ऑफ़-द-आर्ट के दावे उन्हीं बेंचमार्क्स पर मापे जाते हैं जिन्हें लेखकों ने चुना है, और यह हमेशा साफ़ नहीं होता कि वे बेंचमार्क कैसे तैयार किए गए थे या क्या वे उन विशिष्ट दस्तावेज़ प्रकारों को शामिल करते हैं जिनकी आपको परवाह है। ख़ास तौर पर PureDocBench के नतीजों पर इससे पहले कि कोई इन्हें जनरलाइज़ेशन का अंतिम प्रमाण माने, और बारीक नज़र डालने की ज़रूरत है।
फिर भी, यहाँ का मूल विचार ठोस है और इस बात पर ध्यान दिया जाना चाहिए—चाहे आगे की जाँच में विशिष्ट आंकड़े खरे उतरें या नहीं: बरसों से डॉक्यूमेंट पार्सिंग को गुपचुप तरीक़े से साफ़, सपाट और अच्छी रोशनी वाले इनपुट्स के लिए ही ऑप्टिमाइज़ किया जाता रहा है, जबकि असल दुनिया में दस्तावेज़ों का एक बड़ा हिस्सा ख़राब रोशनी में फ़ोन के कैमरे से ही कैप्चर किया जाता है। एक ऐसा मॉडल जो ज्योमेट्रिक डिस्टॉर्शन को प्री-प्रोसेसिंग से हटाने के बजाय सीखने योग्य चीज़ मानता है, बिल्कुल सही समस्या को निशाना बना रहा है। क्या यह वही मॉडल है जिसे आपको अपनी पाइपलाइन में शामिल करना चाहिए, यह एक अलग सवाल है—जिसका फ़ैसला किसी बेंचमार्क टेबल पर आँख मूँदकर भरोसा करने के बजाय, अपने खुद के उलझे हुए, असली और फ़ोटो खींचे गए दस्तावेज़ों पर टेस्ट करके ही किया जाना चाहिए।