A IA que lê plantas como um engenheiro, não como um scanner
Baseado em: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
O problema do arquivo morto
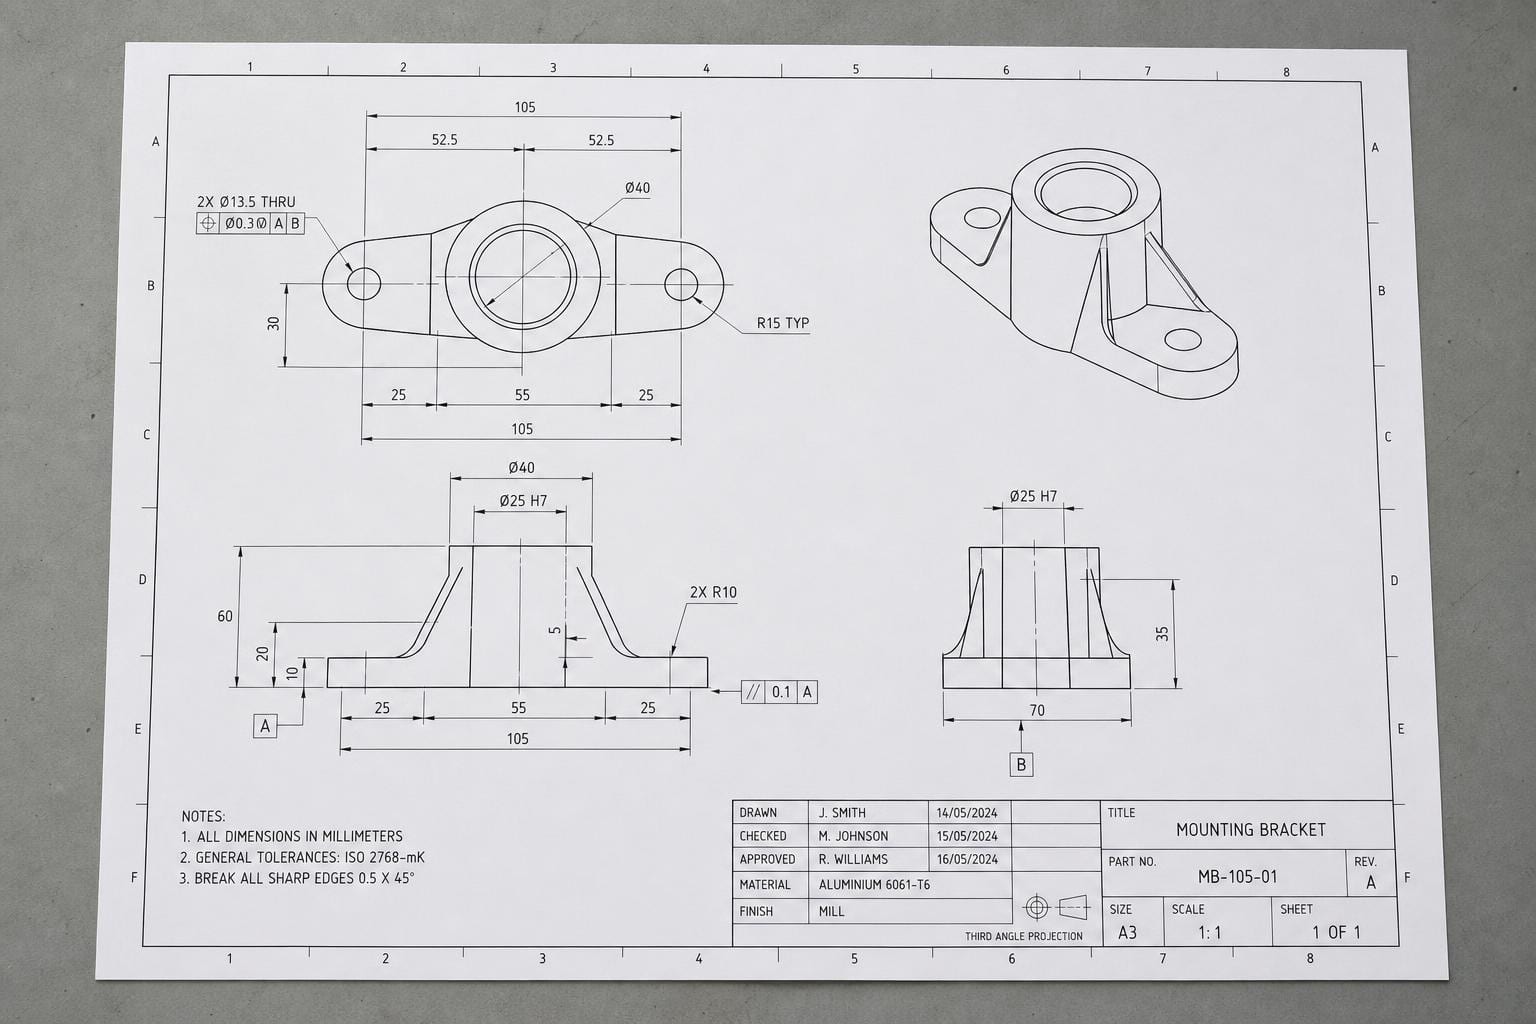
Em alguma fábrica de manufatura, neste exato momento, existe um arquivo cheio de desenhos técnicos de peças que ninguém consegue mais encomendar. Um suporte de 1994, dimensionado à mão, fotocopiado tantas vezes que as linhas ficaram borradas. A empresa que fabricou a peça original desapareceu. O engenheiro que a desenhou se aposentou há uma década. Mas um cliente ainda precisa desse suporte exato, e o único registro dele é um pedaço de papel plano.
Para fabricar essa peça em uma máquina CNC moderna ou uma impressora 3D, alguém precisa transformar o desenho de volta em um modelo 3D paramétrico vivo: não uma imagem da peça, mas um conjunto de instruções que um computador pode redimensionar, editar e usinar. Hoje, isso significa um técnico de CAD sentado e redesenhando tudo à mão, lendo cada dimensão do papel e digitando-a novamente no software. É lento, é caro e é exatamente o tipo de tarefa com um bom sistema de IA deveria poder ajudar.
Um novo artigo chamado Drawing-Recode, dos pesquisadores Mingi Kim, Yongjun Kim e Hyungki Kim, tenta automatizar esse fluxo de trabalho: insira um desenho 2D digitalizado e receba código CAD funcional. O que torna isso interessante não é apenas a tentativa. É o problema específico que os autores identificam como o verdadeiro gargalo, e é um que a maioria dos sistemas adjacentes ao OCR ignora silenciosamente.
A lacuna entre ler um número e entender o que ele mede
Comecemos com uma distinção que é fundamental aqui: raster versus vetor. Um arquivo CAD vetorial (um DXF ou um arquivo nativo do SolidWorks, por exemplo) armazena a geometria como dados estruturados: esta linha vai do ponto A ao ponto B, este círculo tem este raio. Uma imagem raster é apenas pixels. Um desenho escaneado, uma foto de uma planta baixa, um PDF que é, na verdade, uma imagem por baixo, todos esses são raster. Não há estrutura neles, apenas pontos coloridos que parecem linhas e texto para o olho humano.
Ler o texto de um desenho CAD raster é um problema parcialmente resolvido. O OCR pode extrair "Ø25" ou "50.5" de uma página com razoável precisão, incluindo símbolos de cotação. Mas não é disso que se trata o Drawing-Recode.
O problema mais difícil é este: uma vez que você leu "50.5" na página, a que ele pertence? Um desenho CAD não é um formulário com campos rotulados. É uma imagem de uma peça, com uma dispersão de linhas de cotação e números apontando para arestas, furos e superfícies específicas. Um "50.5" perto de um retângulo provavelmente descreve sua largura, mas pode descrever a diagonal, o espaçamento de um furo ou algo a três linhas de distância que a linha de extensão apenas cruza por acaso. Se essa ligação estiver errada, você não obtém uma peça ligeiramente imprecisa. Você obtém uma peça estruturalmente incorreta, porque um modelo CAD paramétrico é uma sequência de operações (esboce este retângulo, extrude-o esta distância, corte este furo) onde cada etapa depende dos números estarem vinculados à geometria correta.
A abordagem do artigo é que os sistemas anteriores funcionam apenas com desenhos vetoriais (que já possuem essa estrutura embutida, então não há nada a resolver) ou são limitados, construídos para um tipo de desenho ou uma indústria específica, e nenhum deles conecta explicitamente uma anotação à geometria que ela descreve. Eles tratam o reconhecimento de texto e o reconhecimento de geometria como tarefas separadas e esperam que a conexão se resolva a jusante. Geralmente, não se resolve.
Como o Drawing-Recode associa um número à linha que ele mede
A arquitetura possui algumas peças distintas, e a mais interessante está no meio.
Primeiro, um codificador de imagens analisa o desenho rasterizado e extrai características geométricas: essencialmente, uma representação interna rica das linhas, curvas e formas na página, independente de qualquer texto. Separadamente, um módulo de reconhecimento de texto lê as anotações: os números de cota, tolerâncias e rótulos espalhados pelo desenho. Até aqui, trata-se de IA para documentos padrão, dois leitores especializados trabalhando em paralelo.
A contribuição real é o que acontece em seguida. O Drawing-Recode usa atenção cruzada, um mecanismo que permite a um conjunto de características "observar" outro conjunto e decidir o que é relevante, para conectar cada anotação reconhecida às características geométricas específicas que ela descreve. Pense nisso como o modelo aprendendo a desenhar suas próprias linhas de cota: dado o texto "50,5", ele aprende a buscar na representação geométrica a aresta que esse número mais plausivelmente mede, da mesma forma que o olho humano segue uma linha de cota do número de volta ao contorno da peça.
Para tornar essa conexão confiável em vez de aproximada, os autores adicionam algo chamado Annotation Grounding Loss (AGL). Uma "perda" (loss) em aprendizado de máquina é simplesmente a penalidade que o modelo recebe durante o treinamento quando sua saída está incorreta, o sinal que ele usa para melhorar. Uma configuração de treinamento normal poderia penalizar o modelo apenas por gerar o código CAD final incorretamente. O AGL adiciona uma penalidade extra e explícita por errar o vínculo entre anotação e geometria, mesmo antes de chegar à saída final. Essa é uma escolha de design deliberada: em vez de esperar que o ancoramento correto surja como um efeito colateral da boa geração de código, eles treinam o modelo para acertar o ancoramento por conta própria.
Uma vez que a geometria, o texto reconhecido e os vínculos ancorados entre eles são combinados em um único conjunto de características, isso é alimentado em um grande modelo de linguagem (LLM), da mesma família de modelos por trás de ferramentas como o ChatGPT, adaptado aqui para gerar código em vez de prosa. A saída não é uma imagem ou um conjunto de coordenadas. É código CAD no que os autores chamam de formato Structured Parametric CAD Code (SPCC): uma sequência de operações como "esboce este perfil, extrude-o 12mm, corte um furo de 6mm aqui" que um programa CAD pode executar para reconstruir o modelo 3D real, totalmente editável, não apenas uma forma estática.
O que descobriram, e a parte que realmente importa para o uso no mundo real
O artigo relata que o Drawing-Recode supera os métodos de referência existentes na recuperação de sequências CAD paramétricas corretas a partir de desenhos raster. Isso era esperado. Qualquer novo método apresentado em um artigo precisa superar o que veio antes, caso contrário, não há artigo.
O resultado mais revelador é a segunda afirmação: o sistema mantém robustez em desenhos digitalizados que se assemelham a condições industriais reais. Vale a pena refletir sobre isso, pois é a diferença entre uma demonstração e uma ferramenta. Renderizações CAD limpas e de alta resolução são o caso fácil. Desenhos do mundo real, aqueles guardados no arquivo, são cópias de cópias, desbotados, levemente rotacionados, com manchas de café e marcas de lápis que a IA precisa contornar. Um sistema que só funciona bem com entradas impecáveis está resolvendo um problema que ninguém realmente tem. Os autores projetaram e testaram especificamente contra digitalizações degradadas, o que sugere que entenderam que o caso "limpo de laboratório" nunca foi o objetivo.
Dito isso, o resumo não fornece os números concretos, porcentagens de precisão, comparações exatas com as linhas de base ou tamanhos dos conjuntos de dados, então trate "supera" e "mantém robustez" como afirmações direcionais respaldadas por experimentos, em vez de um placar que você possa citar diretamente. Se você está decidindo se deve construir sobre isso, o mecanismo (ancoragem explícita via cross-attention e uma função de perda dedicada) é a ideia transferível, mais do que qualquer número específico de benchmark neste artigo inicial.
Por que isso importa para quem constrói ou escolhe OCR
Se ampliarmos o foco além do CAD especificamente, há uma lição aqui para a IA de documentos em geral, que é exatamente o domínio do OpenOCR.
Uma grande quantidade do processamento de documentos do mundo real não é apenas "ler o texto". É "descobrir a qual elemento cada texto pertence". Um item de linha de uma fatura precisa estar vinculado ao SKU correto e ao total correto. A caixa de seleção de um formulário médico precisa estar vinculada ao rótulo ao lado dela, não ao rótulo três linhas acima. O marcador de nota de rodapé de uma declaração financeira precisa estar vinculado ao número que ele anota. Em todos esses casos, o OCR puro fornece os caracteres, mas falha completamente em fornecer o relacionamento. É geralmente nesse relacionamento que reside o valor real.
O Drawing-Recode é um estudo de caso claro na resolução intencional desse problema de relacionamento, em vez de esperar que um modelo grande o aprenda por acaso. A escolha de design explícita, uma função de perda dedicada apenas para o grounding (ancoragem) e uma cross-attention arquitetonicamente forçada a conectar as duas modalidades, é a parte que vale a pena lembrar, mesmo que você nunca toque em um desenho CAD. Ao avaliar um mecanismo de OCR ou IA de documentos para uma tarefa que envolve anotações, rótulos ou referências cruzadas (não apenas texto corrido), pergunte ao fornecedor se seu sistema modela explicitamente esses links ou apenas extrai texto e geometria separadamente, deixando que você os una. O abismo entre essas duas abordagens é geralmente onde residem os problemas de precisão.
Para usuários do OpenOCR especificamente, isso também aponta para uma categoria que vale a pena observar: mecanismos construídos para uma tarefa estreita, mas profunda, como a digitalização de peças, tendem a superar o OCR de propósito geral nessa tarefa, mesmo quando o mecanismo de propósito geral tem um orçamento de treinamento maior por trás. Se você está digitalizando arquivos de engenharia, a jogada certa provavelmente não é executar um mecanismo de OCR genérico e escrever código de integração personalizado para adivinhar a quais linhas os números pertencem. É encontrar ou construir algo mais próximo da abordagem do Drawing-Recode, onde o vínculo faz parte do modelo, não um acessório adicionado no pós-processamento.
Onde isso ainda fica aquém
Algumas lacunas se destacam, algumas reconhecidas pela própria estrutura do artigo, outras inerentes à abordagem descrita.
O escopo são desenhos 2D que produzem sequências paramétricas 3D para peças individuais, não conjuntos completos. Um arquivo de manufatura real não é apenas desenhos de peças únicas; são desenhos de conjuntos com múltiplas peças, sub-referências e chamadas cruzadas entre folhas ("ver detalhe na folha 3"). Nada no resumo sugere que o Drawing-Recode lida com esse caso mais amplo ainda.
Há também o risco padrão com qualquer geração de código baseada em LLM: uma saída fluente e estruturalmente válida não é a mesma que uma saída dimensionalmente correta. Uma sequência SPCC gerada pode parecer correta, extrudar a forma certa na direção certa e ainda assim ser construída a partir de um número mal lido ou de uma decisão de ancoragem ligeiramente equivocada. Para um post de blog, é uma curiosidade. Para uma peça manufaturada que será parafusada em uma máquina, é a diferença entre uma peça de reposição funcional e um erro muito caro. Nada no resumo descreve uma etapa de verificação a jusante que verifique o código gerado contra tolerâncias físicas, que é o tipo de salvaguarda que isso precisa antes que alguém o aponte para peças de produção sem supervisão.
E como a maioria dos modelos de reconhecimento especializados, a qualidade dos dados de treinamento é o limite. Um modelo tão ajustado para ler convenções de anotação específicas de CAD é presumivelmente treinado em dados específicos de CAD, o que significa que seu desempenho em estilos de desenho, convenções de símbolos ou indústrias fora dessa distribuição de treinamento é uma questão em aberto que o artigo não afirma responder.
Nada disso mina a ideia central. Ancorar explicitamente anotações à geometria, em vez de tratar o reconhecimento de texto e o reconhecimento de forma como dois trabalhos que acontecem por acaso próximos um do outro, é o instinto certo, e é algo que todo o campo de IA para documentos poderia se beneficiar em adotar com mais frequência.