像工程师而非扫描仪那样阅读蓝图的AI
参考论文: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
从图纸到代码:Drawing-Recode 如何自动化逆向工程
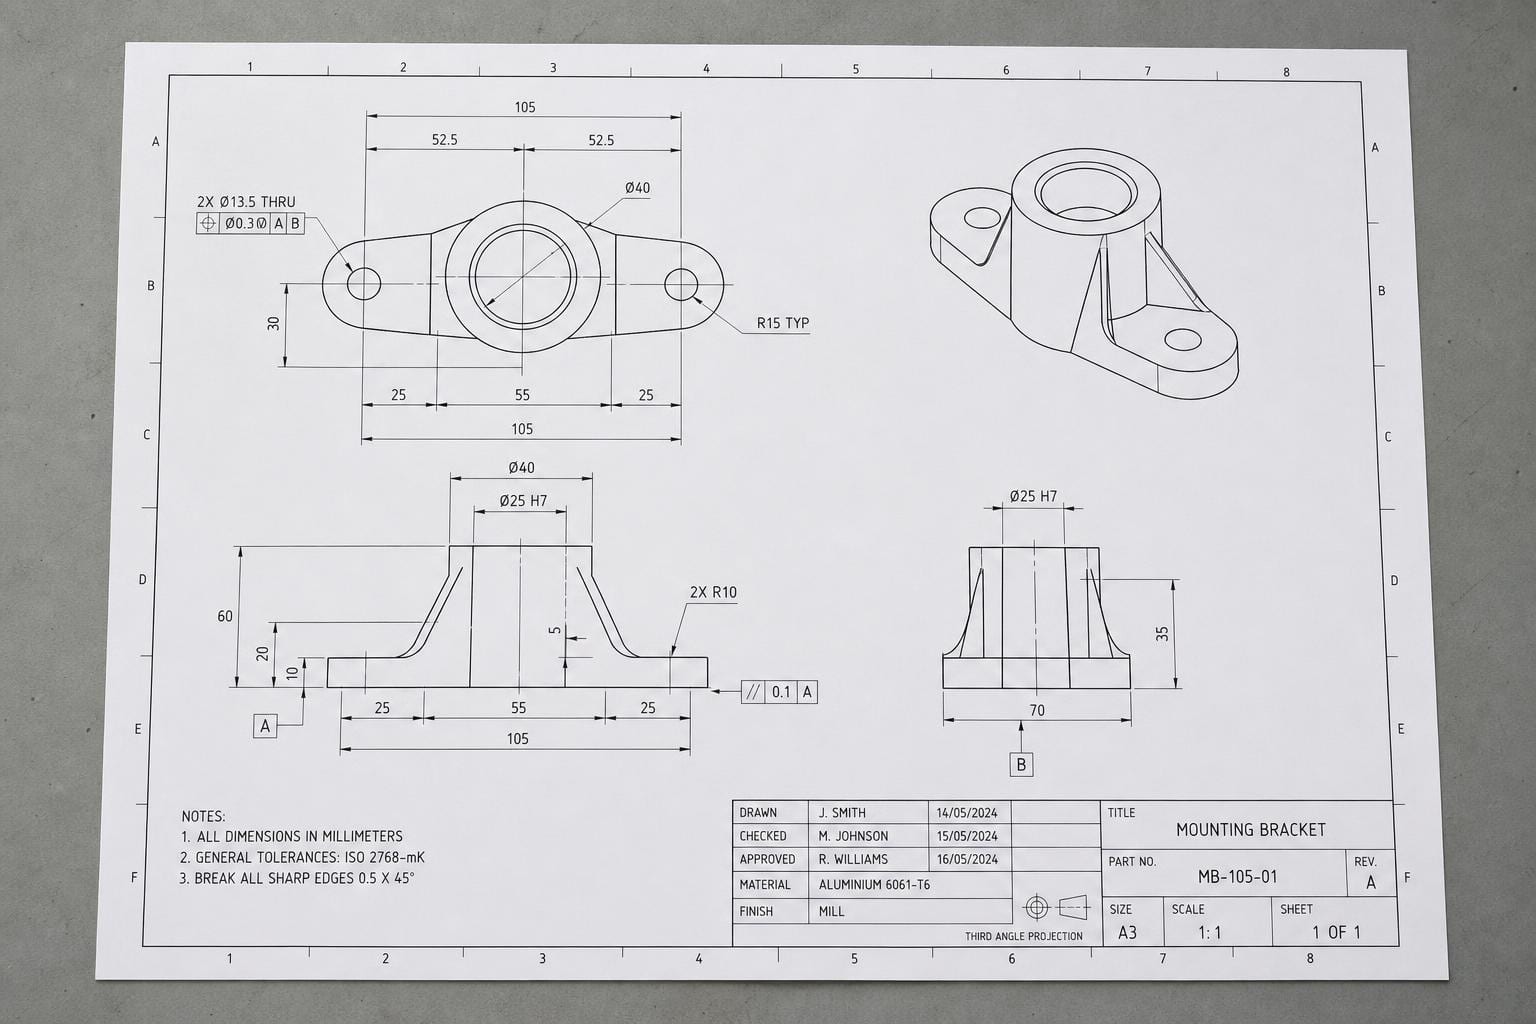
此刻,在某个制造工厂里,可能正有一个文件柜,里面堆满了再也无法订购的零件图纸。那是一张 1994 年的支架图纸,尺寸由人工标注,经过无数次复印,线条已经模糊不清。生产原始零件的公司早已不复存在,绘制该图纸的工程师也在十年前退休了。但客户仍然需要那个完全相同的支架,而唯一的记录就是一张平面的纸张。
要在现代 CNC 机床或 3D 打印机上制造该零件,必须将图纸重新转化为可编辑的参数化 3D 模型:这不仅仅是一张零件的图片,而是一组计算机可以调整大小、编辑和加工的指令。目前,这意味着一名 CAD 技术员必须坐下来手工重绘整个模型,从纸上读取每个尺寸并重新输入到软件中。这个过程缓慢、昂贵,而且正是 AI 系统理应能够协助完成的典型任务。
由研究人员 Mingi Kim、Yongjun Kim 和 Hyungki Kim 撰写的一篇名为《Drawing-Recode》的新论文,试图自动化这一流程:输入扫描的 2D 图纸,输出可用的 CAD 代码。其有趣之处不仅在于它尝试完成这一任务,更在于作者指出的真正瓶颈问题——这也是大多数与 OCR 相关的系统往往默默忽略的问题。
读取数字与理解其度量对象之间的差距
首先明确一个在此处至关重要的区别:光栅与矢量。矢量 CAD 文件(例如 DXF 文件或 SolidWorks 原生文件)将几何形状存储为结构化数据:这条线从点 A 运行到点 B,这个圆的半径是多少。而光栅图像仅仅是像素。扫描的工程图、蓝图照片、底层实质上是图片的 PDF,这些都属于光栅图像。它们内部没有任何结构,只有恰好被人眼识别为线条和文本的彩色点阵。
从光栅 CAD 图纸中读取文本是一个大致已解决的问题。OCR 可以相当好地从页面上提取出“Ø25”或“50.5”等数值,包括尺寸符号。但这并不是 Drawing-Recode 真正关注的核心。
更困难的问题在于:一旦你从页面上读取了“50.5”,它究竟对应什么?CAD 图纸并不是带有标签字段的表单。它是一张零件的图片,上面散布着指向特定边缘、孔洞和表面的尺寸线与数字。矩形附近的“50.5”可能描述的是其宽度,但也可能描述的是对角线、孔间距,或者是延伸线恰好穿过的、位于三行之外的某个对象。如果这种关联出错,你得到的不仅仅是一个略有偏差的零件,而是一个结构错误的零件。因为参数化 CAD 模型是一系列操作序列(绘制此矩形、拉伸此距离、切割此孔),其中每一步都依赖于数字被正确绑定到相应的几何元素上。
该论文的框架指出,先前的系统要么仅适用于矢量图纸(这些图纸已内置结构,因此无问题可解),要么范围狭窄,专为某一种图纸或某一行业构建,且没有任何系统明确地将注释与其所描述的几何形状连接起来。它们将文本识别和几何识别视为两项独立的任务,并希望这种关联能在下游自行理顺。但通常事实并非如此。
Drawing-Recode 如何将数字与其测量的线条关联起来
该架构由几个不同的部分组成,其中有趣的部分位于中间。
首先,图像编码器观察光栅绘图并提取几何特征:本质上,这是页面上线条、曲线和形状的丰富内部表示,独立于任何文本。与此同时,文本识别模块读取注释:散布在绘图上的尺寸数字、公差和标签。到目前为止,这是标准的文档 AI,两个专门的阅读器并行工作。
真正的贡献在于接下来发生的事情。Drawing-Recode 使用交叉注意力(cross-attention),这是一种让一组特征“查看”另一组特征并决定哪些相关的机制,从而将每个识别出的注释连接回它所描述的具体几何特征。可以将其视为模型学习绘制自己的延伸线:给定文本“50.5”,它学习在几何表示中搜索该数字最可能测量的边缘,就像人眼沿着尺寸线从数字回到零件轮廓一样。
为了使这种连接可靠而不是近似,作者添加了他们称为注释接地损失(Annotation Grounding Loss, AGL)的东西。在机器学习中,“损失”只是模型在训练期间因输出错误而受到的惩罚,它是模型用来改进的信号。正常的训练设置可能只会在模型最终 CAD 代码出错时对其进行惩罚。AGL 增加了一个额外的、明确的惩罚,用于在到达最终输出之前错误地建立注释与几何之间的链接。这是一个深思熟虑的设计选择:他们不是希望正确的接地作为良好代码生成的副作用而出现,而是训练模型在其自身的基础上正确地进行接地。
一旦几何、识别的文本以及它们之间的接地链接被组合成一个特征集,这些数据就会被输入到一个大型语言模型(LLM)中,这是与 ChatGPT 等工具背后相同系列的模型,在这里经过调整以生成代码而不是散文。输出不是图片或一组坐标。它是作者称为结构化参数化 CAD 代码(Structured Parametric CAD Code, SPCC)格式的 CAD 代码:一系列操作,如“绘制此轮廓,拉伸 12mm,在此处切割 6mm 的孔”,CAD 程序可以执行这些操作以重建实际的 3D 模型,完全可编辑,而不仅仅是一个静态形状。
他们的发现,以及对实际应用真正重要的部分
论文报告称,Drawing-Recode 在从光栅图纸恢复正确的参数化 CAD 序列方面,优于现有的基线方法。这在意料之中。任何新提出的方法都需要超越之前的成果,否则这篇论文也就没有发表的价值了。
更具说服力的结果是第二个主张:该系统在处理类似于真实工业条件的扫描图纸时,依然保持稳健。这一点值得细细品味,因为它区分了“演示”与“工具”。清晰、高分辨率的 CAD 渲染图是容易处理的案例。而现实世界中的图纸——那些躺在档案柜里的文件——往往是复印件的复印件,褪色、轻微旋转,还带有咖啡渍和铅笔痕迹,AI 必须绕过这些干扰。一个仅在完美输入上表现良好的系统,解决的并不是任何人真正面临的问题。作者专门针对并测试了退化扫描图,这表明他们明白,实验室级别的干净案例从来都不是重点。
话虽如此,摘要并没有提供具体的数字、准确率百分比、精确的基线对比或数据集规模,因此请将“优于”和“保持稳健”视为由实验支持的定性主张,而非可以直接引用的具体分数。如果你正在决定是否基于此进行开发,其机制(通过交叉注意力和专用损失函数实现的显式接地)才是可迁移的核心思想,比这篇早期论文中的任何具体基准数字都更重要。
为什么这对构建或选择 OCR 的人很重要
跳出 CAD 的具体场景,这里有一个对文档 AI 普遍适用的教训,而这正是 OpenOCR 的核心领域。
大量现实世界的文档处理任务并非简单的“读取文本”,而是“确定哪些文本属于哪些对象”。发票中的明细行需要关联到正确的 SKU 和正确的总额;医疗表单中的复选框需要关联到旁边的标签,而不是三行之前的标签;财务报表中的脚注标记需要关联到它所注释的数字。在所有这些案例中,纯 OCR 只能给你字符,却完全无法捕捉它们之间的关系。而这种关系往往才是实际价值的所在。
Drawing-Recode 是一个清晰的案例研究,它旨在专门解决这种关系问题,而不是指望足够大的模型能偶然学会它。 这种明确的设计选择——包括专为定位(grounding)设计的损失函数,以及在架构上强制连接两种模态的交叉注意力机制——即使你从不处理 CAD 图纸,也值得铭记。当你在评估用于涉及注释、标签或交叉引用(而不仅仅是连续文本)任务的 OCR 或文档 AI 引擎时,询问供应商他们的系统是否显式建模了这些链接,还是仅仅分别提取文本和几何信息,然后留给你去拼接。这两种方法之间的差距通常就是准确性问题所在。鉴于中文排版密集且字符繁多,若模型仅针对英文拉丁字符优化,其在处理此类复杂空间关系时往往难以直接迁移至中文场景。
对于 OpenOCR 用户而言,这也指向了一个值得关注的类别:为狭窄但深入的任务(如零件数字化)构建的引擎,通常在该任务上胜过通用 OCR,即使后者拥有更大的训练预算。如果你正在数字化工程档案,正确的做法可能不是运行通用 OCR 引擎并编写自定义胶水代码来猜测哪些数字属于哪些线条,而是寻找或构建更接近 Drawing-Recode 方法的工具,其中链接是模型的一部分,而不是事后在后期处理中附加的。
目前的局限性
有几个明显的不足,有些在论文的框架中已得到承认,有些则是该方法的固有局限。
其适用范围仅限于将 2D 图纸转换为单个零件的 3D 参数化序列,而非完整的装配体。真实的制造档案不仅仅是单个零件的图纸,还包括包含多个零件、子引用以及跨页标注(如“参见第 3 页详图”)的装配图。摘要中并未暗示 Drawing-Recode 目前能处理这种更广泛的情况。
此外,任何基于 LLM 的代码生成都面临一个标准风险:流畅且结构有效的输出并不等同于尺寸正确的输出。生成的 SPCC 序列可能看起来没问题,也能在正确的方向上挤出正确的形状,但如果源于数字误读或略微错误的定位决策,结果依然会出错。对于博客文章而言,这只是一个有趣的现象;但对于需要螺栓固定在机器中的制造零件来说,这决定了它是可用的替换件还是一个代价高昂的错误。摘要中并未描述任何下游验证步骤来检查生成的代码是否符合物理公差,而在无人监督地将其应用于生产零件之前,这是必须建立的护栏。
与大多数专用识别模型一样,训练数据的质量决定了性能上限。这种针对阅读 CAD 特定注释约定进行优化的模型, presumably 是在 CAD 特定数据上训练的,这意味着其在训练分布之外的绘图风格、符号约定或行业中的表现,是一个论文并未声称要回答的开放性问题。
这些局限并未削弱其核心理念。将注释显式地锚定到几何体上,而不是将文本识别和形状识别视为两个恰好同时运行的独立任务,这一直觉是正确的,整个文档 AI 领域都应更多地借鉴这一思路。